Nanosaur 2レビュー:670Mの小型イラスト生成モデルでできること・苦手なこと
Nanosaur 2を実用目線でレビュー。670Mモデル、ComfyUI導入、速度報告、オンライン利用、比較、NSFW情報、ライセンスと限界を解説します。

2026年10月12日更新
Nanosaur 2は、少ない計算資源でどこまで画像を生成できるかを探る、小型のオープンなイラストモデルです。拡散Transformerは670Mパラメーターで、ダウンロードできるComfyUIワークフローも公開されています。一方、開発者自身が、キャラクター知識や細部の描写ではAnimaのような成熟モデルに及ばないと説明しています。
見るべき点は、大型モデルの代わりになるかどうかだけではありません。小さなモデルをローカルで動かし、仕組みを調べ、LoRAを試す用途に価値があります。初期の利用報告では、キャラクターの描写や省メモリ性が評価される一方、背景、手や目の安定性、seedを変えたときの構図には課題が挙がっています。
目次
まず結論:小型モデルの研究・実験向け
| 項目 | 公式情報 |
|---|---|
| モデル | 670Mパラメーターのイラスト向けDiT |
| テキストエンコーダー / VAE | Gemma 3 270M / DINOv2セマンティックVAE(129M) |
| 基本設定 | Euler Simple、50ステップ、CFG 4 |
| 学習コスト | 開発者によると約600米ドル |
| ライセンス / 用途 | MIT表記、モデルカードは研究目的と説明 |
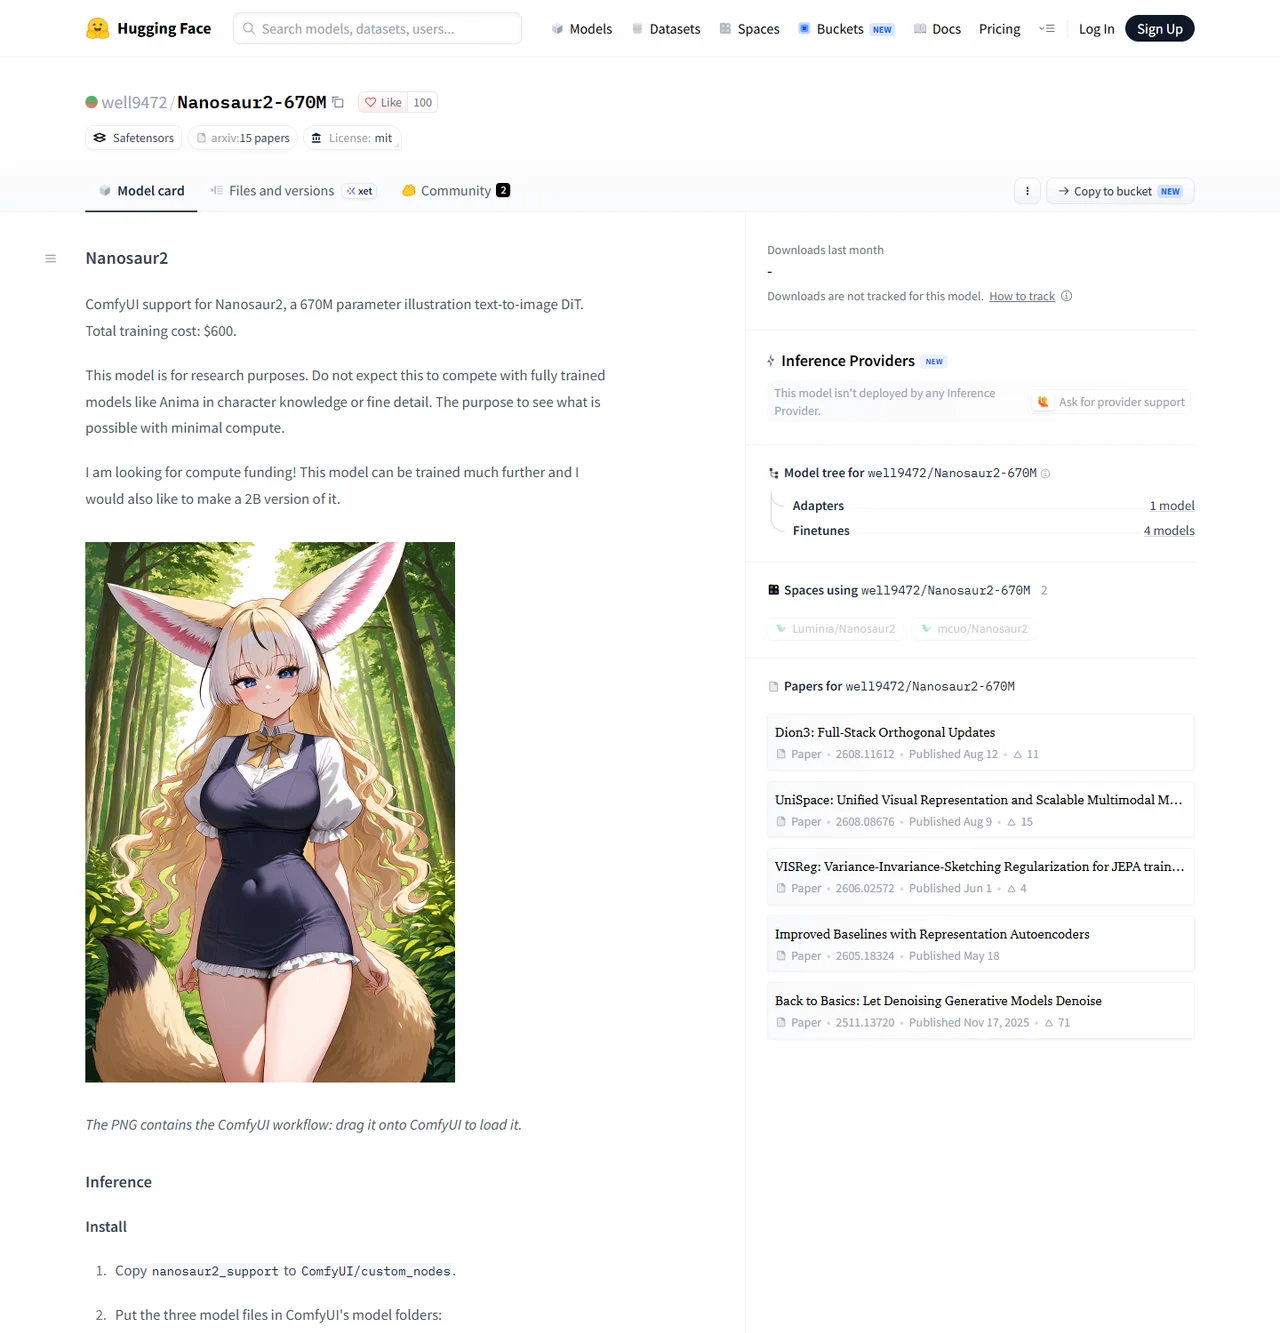
Nanosaur 2は、コンパクトなイラストモデルをローカルで動かしたい人、構造を学びたい人、LoRAを試したい人に向いています。公式モデルカードでは670MのDiT、Gemma 3 270Mのテキストエンコーダー、129MのセマンティックVAE、1024ピクセルのアスペクト比バケット、50ステップのEuler Simpleが案内されています。開発者は学習計算費用を約600ドルと記載しています。
モデルの概要
公式Hugging Faceカードでは、Nanosaur2-670Mはイラスト向けのテキスト画像生成DiTとして説明されています。Gemma 3 270MのテキストエンコーダーとDINOv2ベースのセマンティックVAEを組み合わせ、開発者は低い計算コストでゼロから学習した研究プロジェクトとしています。
プロンプトは自然文とタグ形式の両方を使えます。基本設定はEuler Simple、50ステップ、CFG 4、1024ピクセルのアスペクト比バケットです。カードではポジティブ側に「newest, masterpiece」などの品質タグを付ける方法や、作家タグの重み付けにも触れています。まずは推奨設定を出発点にしてください。
まず基本モデルを動かし、4ステップ版と比較する
Nanosaur 2はSDXL用チェックポイント1個で動くモデルではありません。専用ローダー、テキストエンコーダー、VAEを組み合わせます。最初に基本ワークフローを保存しておくと、拡張機能の不具合とモデル自体の限界を切り分けやすくなります。
- 開発者のリポジトリからサポートフォルダーと3種類のモデルファイルを取得します。nanosaur2_supportフォルダー全体をComfyUI/custom_nodesに配置し、同名フォルダーを二重に入れないようにします。
- 下表の場所に各ファイルを置き、ComfyUIを再起動してnanosaur2_workflow.jsonをキャンバスへドラッグします。公式サンプルPNGにもワークフローが含まれますが、SNSで再圧縮された画像ではメタデータが失われる場合があります。
- Nanosaur2Loaderで正しいファイル名を選びます。バッチサイズ1、付属ワークフローの解像度から始め、LoRAやアップスケーラーを追加する前に基本構成で生成します。
- 高速版は専用の拡散モデルとnanosaur2_dmad_4step_workflow.jsonを取得します。テキストエンコーダーとVAEもそのグラフどおりに指定します。通常版のステップ数だけを50から4に下げても、4ステップ版にはなりません。
| ダウンロード | ComfyUI内の配置先 |
|---|---|
| nanosaur2_diffusion_model.safetensors | models/diffusion_models |
| nanosaur2_text_encoder.safetensors | models/text_encoders |
| nanosaur2_vae.safetensors | models/vae |
| nanosaur2_support | custom_nodes |
nanosaur2_workflow.json · DMAD 4-step checkpoint · nanosaur2_dmad_4step_workflow.json
| ワークフロー | サンプラー/スケジューラー | ステップ数/CFG | 初回の解像度 |
|---|---|---|---|
| 基本モデル | Euler / simple | 50 / 4 | 1024クラスのアスペクト比バケット |
| DMAD 4ステップ版 | LCM / simple | 4 / 1 | 832 × 1216 |
配布中の4ステップJSONはLCM/simple、4ステップ、CFG 1、denoise 1、832 × 1216を使用します。同じpositive conditioningがサンプラーの両入力につながっています。基本モデルのCFG 4やネガティブ設定を流用せず、グラフ全体を読み込んでください。基本モデルはEuler/simple、50ステップ、CFG 4で、推論時のshift 3はモデル側に組み込まれています。
比較しやすい最初のプロンプト
以下は試用向けの提案例で、この条件で生成・評価した実測結果ではありません。人物1人、動作1つ、簡単な背景から始めます。ネガティブ例は基本ワークフロー用です。
newest, masterpiece, an adult woman explorer in a blue jacket, standing beside a quiet forest lake, medium shot, soft morning light, simple background, illustrationoldest, low quality4つの固定seedで比較し、目、手、服の輪郭、人物と背景の境界を等倍で確認します。タグは属性の指定に、自然文は動作の説明に向いています。長文の指示が反映されないときは品質タグを増やすより、競合する条件を減らします。独自の重み付けはcross-attention biasに作用するため、他モデルの数値をそのまま移しても同じ効き方にはなりません。
読み込み・生成で失敗したとき
- Nanosaur2Loaderが見つからない:起動ログのカスタムノードエラーとフォルダー位置を確認し、再起動します。
- モデル一覧に出ない:ファイル名と配置先を確認します。3種類ともcheckpointsへ置く構成ではありません。
- メモリー不足:まずバッチ1と低い解像度で確認します。ファイル容量と最大VRAM使用量は別で、エンコード、attention、デコード用のメモリーも必要です。
- 拡張導入後に崩れた:元のサポートフォルダーと基本グラフへ戻します。量子化版や局所修正版は、それぞれ指定されたローダーが必要です。
初期ユーザーの評価
9月のr/StableDiffusionの投稿では、ある利用者がモデルサイズの割にキャラクター描写がよいと評価する一方、背景が粗い、構図が重複しやすい、背景人物は苦手と報告しています。別のユーザーは8GBのRTX 3070で50ステップ約17秒と書いていますが、特定環境での個人報告であり、再現性のあるベンチマークではありません。
小さいモデルでも「2 GBで必ず動く」とは限らない
670Mは拡散Transformer部分の数値です。1パラメーター2バイトとして単純計算すると、その重みだけで約1.34 GBになり、270Mのエンコーダー、129MのVAE、実行用バッファーは別です。これはVRAMの実測値ではありません。コミュニティには4~8 GB級GPUや8 GB RTX 3070の話がありますが、開発者が保証した最低構成表はありません。古いGPUはPyTorchやデータ型の対応も確認が必要です。
10月5日の「毎秒7枚」はRTX 5090での4ステップ構成の報告です。4~8 GBのGPUでも同じ速度になるわけではありません。また、連続処理のスループットと、モデル読み込みを含む初回の待ち時間は別です。同じ解像度・バッチ数で初回と2回目以降を分けて測りましょう。ステップ削減は試行を速めますが、細部や構図が同一になる保証はありません。
Reddit · 2026-09-26 · Reddit · 2026-10-05
他の画像生成モデルとの比較
| モデル | 向いている用途 | 確認できること |
|---|---|---|
| Nanosaur 2 (670M) | 小型ローカル実験、LoRA研究 | 小型DiT。開発者はAnimaより知識・細部で劣ると説明 |
| Anima 2.9B | アニメイラスト、キャラクター知識 | より大規模。ここでは直接比較していない |
| SDXL | 汎用画像生成と幅広いツール | 異なるエコシステム。同条件の比較は未確認 |
Anima-2.9BはCircleStone LabsのAnimaを拡張・追加学習した第三者モデルで、元のAnimaと同一ではありません。独自のカードには非商用条件があります。SDXLは対応LoRAや編集ツールの選択肢を重視する場合に有力です。Nanosaurは小ささと実験のしやすさが主な利点で、この比較は用途に基づく評価であり、実測ランキングではありません。
NSFW対応:生成できるか、品質、公開先の規則を分ける
コミュニティの紹介ではuncensoredと表現され、成人向けイラストへの関心もあります。ただしこれはローカルモデルの紹介表現で、品質評価ではありません。モデルカードに統制された成人向け生成テストや詳しいモデレーション仕様はなく、紹介投稿と現行カードでは学習画像数の説明も異なります。公開仕様は開発者のカードを優先して読むのが妥当です。
実用上は、成人のみを対象とした指示への追従、人体構造の整合性、seedを変えた再現性が重要です。公開情報だけでは、その成功率を数値で示せません。通常のイラストで見える小型モデルの弱点も残り得ます。このレビューで統制されたNSFW生成テストは行っていません。ローカル利用の自由度と、クラウド事業者や投稿先が許可する内容は別に確認してください。
Nanosaur2-670M · r/StableDiffusion
ダウンロード・オンライン利用・費用
重みとワークフロー自体に購入代金はありません。公式の月額プランやAPI従量料金も公表されていません。ローカルでは保存容量・電気代・機材、クラウドGPUではダウンロード中や待機中の時間、ストレージにも費用がかかります。作者の約600米ドルという学習費は利用料金ではなく、再学習の費用保証でもありません。
第三者のLuminia/Nanosaur2 Spaceは存在しますが、2026年10月12日の確認時点でPAUSEDでした。常時使える公式サービスではありません。開発者運営の公開APIや稼働中の公式ホスト型サービスも確認できていません。確実に使いたい場合はローカルComfyUI、または自分で設定したクラウド環境が中心です。
基本リポジトリにはMITライセンスが表示され、研究用途のプロジェクトと説明されています。再配布時は必要なライセンス表示を確認してください。重みのライセンスだけで、学習元画像・キャラクター・生成物の権利まで一律に解決するわけではありません。比較対象のAnima-2.9Bは非商用ライセンスで、条件が異なります。
Nanosaur2-670M · Luminia/Nanosaur2 · INT8-ConvRot
LoRA・局所修正・VAEで用途を広げる
基本リポジトリのtrain_lora.pyは、画像と同名の.txtキャプションを入れたフォルダーからLoRAを学習し、models/lorasへ保存します。指定ローダーはLoraLoaderModelOnlyです。学習時のメモリーと時間は推論時とは別なので、低VRAMで生成できても快適に学習できるとは限りません。
levzaltのInpaint-ControlNetはコミュニティによるマスク編集拡張です。付属のnanosaur2_support全体へ置き換える手順であり、同じパッケージを別名で重複導入しません。専用ワークフローで元画像とマスクを設定し、縦横を16の倍数に合わせます。テンプレートは896 × 1152です。他のControlNet全般が使えることを意味しません。
GAN-VAEもコミュニティ拡張です。作者は小規模な検証画像で復元誤差が少し改善したと説明していますが、その画像群はチェックポイント選定にも使われています。幅広い画質向上を証明する比較ではありません。同じlatentを元のVAEと比較し、プロンプトの誤解や人体構造まで直るとは期待しない方が適切です。
train_lora.py · Inpaint-ControlNet · GAN-VAE
uv run python custom_nodes/nanosaur2_support/train_lora.py /path/to/images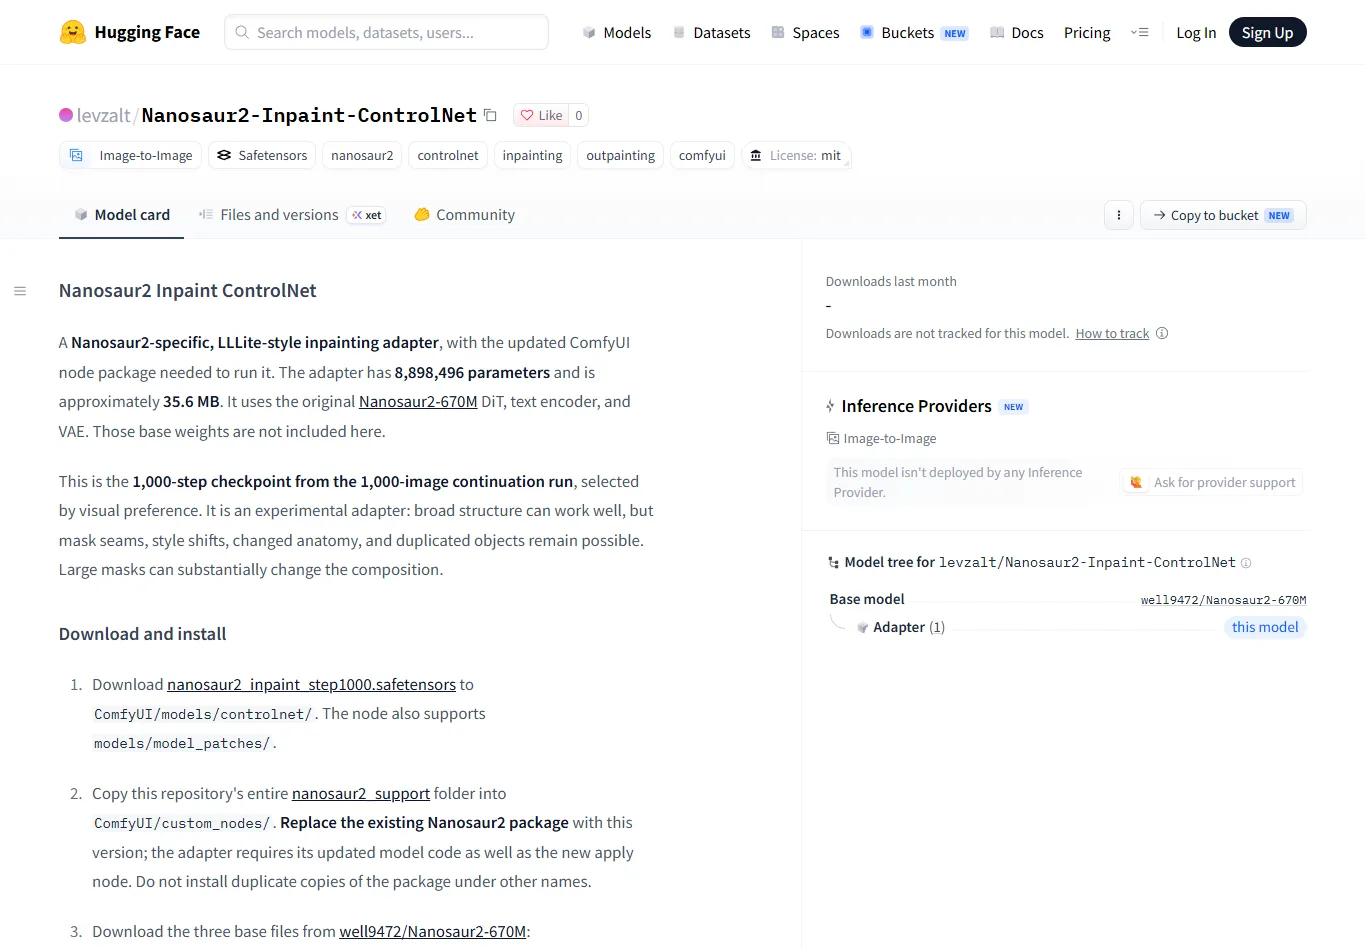
向いている人・向いていない人
小さめのGPUで試したい人、ComfyUIのモデル連携を学びたい人、小型拡散モデルを研究したい人、特定の作風のLoRAを作りたい人には試す価値があります。コンポーネントが分かれ、ワークフローも公開されているため、仕組みを追いやすいプロジェクトです。
背景の細部、複数人物の安定性、手の仕上がり、厳密な指示追従が必要なら、より成熟したイラストモデルを選びましょう。Nanosaur 2は小型の研究ベースとして、また低コストの実験台として面白い存在ですが、すぐに制作へ投入できる代替モデルとは言い切れません。
使う前に知っておきたいこと
Nano Bananaの新バージョンですか?
違います。Nanosaur2-670Mは独立した小型イラストモデルです。名称が似ていても、開発元やモデル系統が同じとは限りません。
どの版から導入すればよいですか?
基本ファイルと標準ワークフローで動作確認し、その後DMADの専用重みと4ステップグラフを追加して比較する方法がおすすめです。
SDXL用LoRAやControlNetは使えますか?
互換性は前提にできません。Nanosaur用LoRAや、手順が公開されている専用拡張を使います。
文字やロゴを正確に描けますか?
文字描画は得意分野ではありません。紹介投稿でも弱点とされています。イラスト生成後、文字は編集ソフトで加える方が確実です。
オンラインAPIはありますか?
公式の有料APIは確認できていません。コミュニティSpaceは2026年10月12日時点で停止中です。モデル配布ページは生成サービスそのものではありません。
毎秒7枚は自分のGPUでも出ますか?
保証できません。話題の数値は5090の構成です。同じ解像度・バッチ数で、初回と読み込み後を分けて自分の環境を測定してください。
まとめ
Nanosaur 2は、ComfyUIワークフローが整った小型イラストモデルで、学習コストの低さと公開された構成が魅力です。一方、構図や細部の課題、独立したベンチマークの不足もあります。
小型モデルの仕組みを学びたい、LoRAのアイデアを試したいならローカルで触れてみる価値があります。安定した完成画像が必要な場合は成熟モデルを使い、Nanosaur 2は比較・研究用として扱うのがよいでしょう。
関連 レビュー
Step 5 Previewレビュー:料金・API・オープンウェイト・NSFW制限を解説

ローカル環境用アニメAI画像生成モデル比較:Anima・NoobAI XL・Illustrious XL・Pony XL
Llama 4レビュー|Scout・Maverick・Behemoth、ローカル導入、NSFW対応まで解説

Z-Imageレビュー|Turbo・Baseの性能、VRAM、LoRAと使い方を解説
MiniMax H3 Image Studioレビュー|ComfyUIで画像生成・参照編集から動画制作へ
Ideogram 4.0レビュー|審査制限突破・NSFW、文字生成AIとComfyUI活用を解説