MiniMax-Music3 im Test: Open-Weight-KI-Musikmodell für 5-Minuten-Songs
MiniMax-Music3 ist ein KI-Modell zur Musikgenerierung mit offenen Gewichten, das vollständige Songs mit einer Länge von bis zu fünf Minuten aus Liedtexten und einer detaillierten…


MiniMax-Music3 ist ein KI-Modell zur Musikgenerierung mit offenen Gewichten, das vollständige Songs mit einer Länge von bis zu fünf Minuten aus Liedtexten und einer detaillierten Musikbeschreibung erstellen kann. Anstatt sich nur auf kurze Loops oder Hintergrundclips zu konzentrieren, zielt es auf eine vollständige Songstruktur ab: Intro, Strophe, Refrain, Bridge, Instrumentalteil und Outro.
Das Fazit vorweg: MiniMax-Music3 bietet für die zwanglose Browser-Erstellung nicht dieselbe Benutzerfreundlichkeit wie Suno oder Udio, ist dafür jedoch für Entwickler, ComfyUI-Anwender, Forscher und Kreative, die lokale Workflows bevorzugen, umso interessanter. Zu den größten Stärken zählen die Langform-Struktur, die Steuerung über Liedtexte und Beschreibungen sowie dokumentierte Integrationswege für SGLang-Omni, Diffusers und ComfyUI.
Inhalt
- Was MiniMax-Music3 ist
- Wichtige Funktionen und technische Daten
- Praxiserfahrung und Ausgabequalität
- Download und lokale Einrichtung
- VRAM- und Hardwareanforderungen
- Vergleich mit führenden KI-Musikmodellen
- Lizenz, kommerzielle Nutzung und Urheberrecht
- Prompt-Beispiel
- Häufig gestellte Fragen (FAQ)
- Referenzen
- Zusammenfassung
Was MiniMax-Music3 ist
MiniMax-Music3 ist ein Text-to-Music-Modell, das von MiniMax veröffentlicht wurde. Die offizielle Hugging-Face-Modellkarte beschreibt es als leistungsstarkes Musikgenerierungsmodell für vollständige Songs mit einer Länge von bis zu fünf Minuten, konditioniert auf Liedtexte und eine detaillierte Musikbeschreibung. Es liefert expressive Vocals, sich entwickelnde Arrangements und 32-kHz- sowie 16-Bit-Stereo-WAV-Audio.
Architektonisch kombiniert das Modell ein globales 8B-LLM für die musikalische Langzeitstruktur mit einem lokalen 0,6B-LLM für akustische Details auf Frame-Ebene. Für die Audiosynthese werden Flow Matching und Flow-VAE eingesetzt. Diese Aufteilung ist wichtig, da die Generierung von kompletten Songs nicht nur darin besteht, schöne Audio-Frames zu erzeugen; das Modell muss Themen, Rhythmus, Gesangsidentität und den Verlauf des Arrangements über mehrere Minuten hinweg aufrecht erhalten.
Wichtige Funktionen und technische Daten
| Eigenschaft | Details |
|---|---|
| Modellname | MiniMax-Music3 / MiniMax Music 3 |
| H Hauptanwendungsbereich | Liedbasierte Songgenerierung, Vokalmusik, kurze Hintergrundmusik, Instrumentalerstellung |
| Eingaben | Liedtexte plus Musikbeschreibung / strukturierte Beschreibung |
| Maximale Länge | Bis zu ca. fünf Minuten |
| Ausgabeformat | 32 kHz, 16-Bit-Stereo-WAV |
| Struktur-Tags | [Intro], [Verse], [Pre-Chorus], [Chorus], [Bridge], [Instrumental], [Solo], [Outro] |
| Laufzeit-Routen | SGLang-Omni, Diffusers, ComfyUI |
| Modell-Hosting | Hugging Face und GitHub |
| Lizenz | MiniMax-Music3 Community License |
Der Workflow basiert auf zwei Eingaben. Die Liedtexte definieren die zu singenden Wörter, während die Musikbeschreibung Genre, Subgenre, BPM, Tonart, emotionalen Bogen, Gesangsstil, Instrumentation, Arrangement und Produktionsprofil vorgibt. Für eine präzisere Steuerung empfiehlt die Modellkarte eine strukturierte Beschreibung („Structured Caption“) mit globalen Metadaten, Vokaldetails und dem Arrangement.
Dies ist einer der nützlichsten Unterschiede zu einfacheren Musikgeneratoren. Ein schwacher Prompt lautet etwa „upbeat pop song“. Eine stärkere Beschreibung lautet demgegenüber: „Dance-Pop, 124 BPM, heller weiblicher Gesang, seitenverketteter Synth-Bass, Strophe mit spärlichen Zupfinstrumenten, Refrain mit breitem Schlagzeug und mehrschichtiger Harmonie, sauberer radiotauglicher Mix“. MiniMax-Music3 bietet Ihnen ein Framework, um diese Details explizit auszuformulieren.
Praxiserfahrung und Ausgabequalität
Der einfachste Weg, das Modell kennenzulernen, ist die offizielle Demoseite. Sie enthält Beispiele aus verschiedenen Genres wie Pop, Rock, R&B, Hip-Hop, Dance-Pop, Country, Soul, Funk, Blues, Bossa Nova und Urban. Mehrere Beispiele verwenden englische Titel, zudem gibt es deutschsprachige beziehungsweise chinesischsprachige Beispiele, wodurch sich die Demo gut eignet, um sowohl die allgemeine Musikalität als auch die Handhabung nicht-englischer Sprachen zu überprüfen.
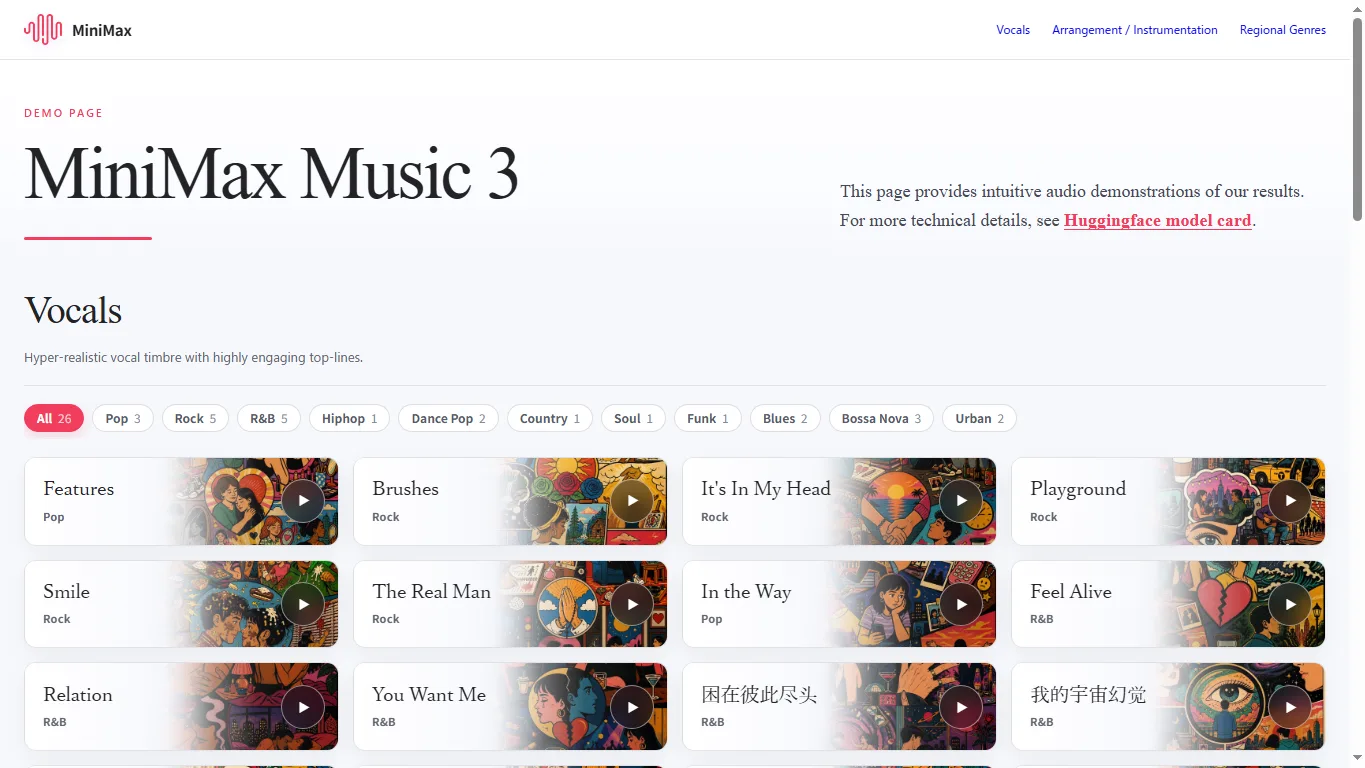
Beim Anhören generierter Songs sollten Sie mehr bewerten als nur den ersten Einstieg. Prüfen Sie, ob der Übergang von der Strophe zum Refrain musikalisch wirkt, ob die Stimmfarbe konsistent bleibt, ob die Liedtexte verständlich sind, ob das Arrangement im Laufe der Zeit an Tiefe gewinnt und ob der Song natürlich ausklingt. Viele KI-Musiksysteme können einen eindrucksvollen 20-sekündigen Clip erstellen; die eigentliche Herausforderung besteht darin, einen vollständigen Song kohärent zu halten.
Das frühe Feedback aus der Community ist enthusiastisch, aber realistisch. Die Diskussionen auf Hugging Face umfassen Lob für die Veröffentlichung mit offenen Gewichten, Fragen zur ComfyUI-Unterstützung, Setups mit geringem VRAM, Lizenzfragen und die Generierungsgeschwindigkeit. Dies verleiht der Veröffentlichung einen sehr spezifischen Charakter: Sie ist beeindruckend und vielversprechend, richtet sich jedoch eher an Personen, die bereit sind, Tests durchzuführen, Feinabstimmungen vorzunehmen und die Dokumentation zu lesen, als an ein reines Ein-Klick-Endverbraucherprodukt.
Download und lokale Einrichtung
Das offizielle Modell ist unter MiniMaxAI/MiniMax-Music3 auf Hugging Face verfügbar, und das Projektrepository befindet sich unter MiniMax-AI/MiniMax-Music3 auf GitHub. Für die serverbasierte Inferenz verweist die Modellkarte auf SGLang-Omni. Ein minimaler Bereitstellungsbefehl sieht folgendermaßen aus:
sgl-omni serve --model-path MiniMaxAI/MiniMax-Music3 --port 8000Generierungsanfragen verwenden das gemeinsame Endpunktformat für Sprachausgabe: Liedtexte werden in input eingefügt, und die Musikbeschreibung wird unter instructions übergeben. Dies ist wichtig, da MiniMax-Music3 kein TTS-Modell mit einem auswählbaren Sprecher ist. Sie steuern das Ergebnis nicht über einen voice-Parameter; stattdessen beschreiben Sie Geschlecht, Timbre, Performance-Stil, Harmonien und Effekte der Vocals in der Beschreibung.
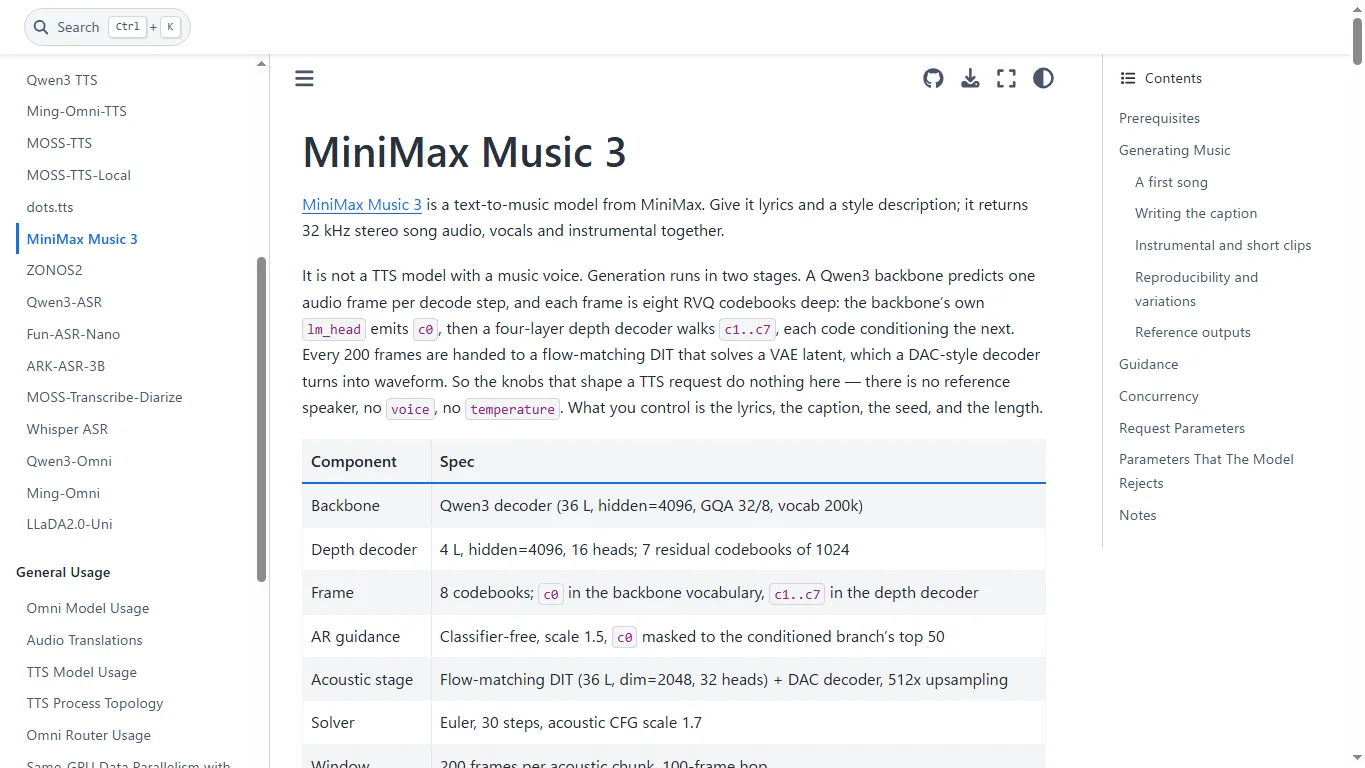
Die Diffusers-Unterstützung ist ebenfalls als ModularPipeline-Route dokumentiert. Zum Zeitpunkt der Erstellung der Modellkarte verweist die Installation auf einen spezifischen Diffusers-PR-Commit; überprüfen Sie daher, ob die vollständige Unterstützung bereits in Ihrer installierten Diffusers-Version enthalten ist, bevor Sie davon ausgehen, dass eine Standard-pip-Installation ausreicht.
VRAM- und Hardwareanforderungen
Die offizielle Modellkarte liefert ein erstaunlich klares Bild der Hardware-Anforderungen. Die volle Präzision passt unter 24 GB VRAM. Bei automatischem CPU-Auslagerungsspeicher (Offloading) nimmt die Generierung etwa 22 GB in Anspruch. Mit schichtweisem Streaming-Offload für das Sprachmodell lässt sich die Pipeline auf 8-GB-Grafikkarten ausführen, was jedoch langsamer ist und eher als Fallback für geringen VRAM denn als ideales Produktions-Setup betrachtet werden sollte.
| Setup | Praktische Einschätzung | Am besten geeignet für |
|---|---|---|
| 24GB+ GPU | Der sauberste lokale Weg; Karten der RTX-4090-Klasse sind realistischer zum Testen | Lokale KI-Anwender und Forscher |
| ~22GB mit CPU-Offload | Spart VRAM, kann jedoch die Geschwindigkeit reduzieren | Anwender knapp unter 24 GB |
| 8GB mit Streaming-Offload | Laut Modellkarte möglich, jedoch deutlich langsamer | Kurze Tests und Machbarkeitsprüfungen |
| ComfyUI Low-VRAM-Pfad | INT8-Modelldateien und kachelbasierte Dekodierung erleichtern Experimente | Kreative, die knotenbasierte Workflows nutzen |
| Cloud-GPU oder API | Geringerer Einrichtungsaufwand und einfacheres Testen langer Songs | Teams und Produktionsvalidierung |
Für ComfyUI-Anwender ist das offizielle ComfyUI MiniMax Music 3 Tutorial der praktischste Ausgangspunkt. Es führt FP16- und INT8-Diffusionsmodelle, einen INT8-Textencoder, VAE-Dateien, die Ordnerplatzierung, den Text-to-Music-Workflow, Tipps zum Verfassen von Prompts und den Speicherort der Ausgaben auf.
Den offiziellen ComfyUI-Workflow herunterladen
Wenn Sie MiniMax-Music3 in ComfyUI testen möchten, verwenden Sie die offizielle Workflow-JSON-Datei von Comfy-Org: audio_minimax_music_3.json. Laden Sie die Datei herunter, laden Sie sie in ComfyUI, und Sie können den Text-to-Music-Workflow direkt untersuchen. Stellen Sie sicher, dass die erforderlichen Modelldateien in den korrekten ComfyUI-Ordnern abgelegt sind, bevor Sie den Prozess starten.
Das offizielle ComfyUI-Tutorial erklärt die Modell-Downloads, Low-VRAM-INT8-Dateien sowie die Einstellungen für max_duration, seed und tiled_decode. Ein pragmatischer Ansatz besteht darin, zunächst kurze Clips zu testen, die Beschreibung und den Liedtext anzupassen und erst danach einen vollständigen drei- bis fünfminütigen Song zu rendern.
Vergleich mit führenden KI-Musikmodellen
MiniMax-Music3 positioniert sich im Bereich zwischen kommerziellen Verbraucherdiensten für KI-Musik und lokalen Forschungsmodellen. Online-Tools wie Suno, Udio und ElevenLabs Music sind einfacher in der Handhabung. Offene Modelle wie Meta MusicGen, Stable Audio Open und YuE sind MiniMax-Music3 konzeptionell ähnlicher, zielen jedoch auf andere Anforderungen hinsichtlich Länge, Steuerung und Workflows ab.
| Modell / Dienst | Typ | Stärke | Zu beachten |
|---|---|---|---|
| MiniMax-Music3 | Modell mit offenen Gewichten | Bis zu fünf Minuten, Liedtexte + detaillierte Beschreibung, ComfyUI-/SGLang-/Diffusers-Routen | Erfordert Einrichtung, VRAM-Planung und Lizenzprüfung |
| Suno | Onlinedienst | Sehr einfacher Browser-Workflow und starkes Endnutzererlebnis | Keine lokale Modellkontrolle oder Bereitstellung offener Gewichte |
| Udio | Onlinedienst | Stark bei Vokal-Songs, Bearbeitung und Verlängerungs-Workflows | Ergebnisse und Nutzungsrechte hängen von den Dienstleistungsbedingungen ab |
| ElevenLabs Music | Online-/API-Dienst | Gut geeignet für Produktions-APIs und Audio-Workflows | Kein lokales Modell mit offenen Gewichten |
| Stable Audio Open | Offenes Modell | Nützlich für kurze Audios, Effekte und Hintergrundelemente | Weniger Fokus auf vollständige liederbasierte Songs |
| Meta MusicGen | Offenes Modell | Etablierte Forschungsbasis für die Erstellung kurzer Musikstücke | Erfordert zusätzliches Workflow-Design für vollständige Gesangssongs |
| YuE | Offenes Modell | Ein relevanter Vergleichspunkt für die Generierung vollständiger Songs | Einrichtung und Ausgabequalität hängen stark von Umgebung und Version ab |
Wenn Ihr Ziel darin besteht, schnell einen Song für soziale Medien zu veröffentlichen, sind Suno oder Udio meist unkomplizierter. Wenn Sie hingegen die Struktur von Langform-Songs testen, Beschreibungen kontrollieren, Seeds verwalten, ComfyUI-Workflows aufbauen oder ein Musikmodell mit offenen Gewichten untersuchen möchten, ist MiniMax-Music3 die interessantere Option.
Auch die breitere Ausrichtung von MiniMax im Bereich der Generierung ist einen Blick wert. Das Videomodell des Unternehmens wird in unserem Testbericht zu MiniMax H3 behandelt, und aktuelle Trends bei der Videogenerierung sind zudem für unseren Testbericht zu LTX-2.5 relevant. Music3 wirkt wie ein Teil derselben Entwicklung hin zu längerer, multimodaler und workflow-freundlicher Generierung.
Lizenz, kommerzielle Nutzung und Urheberrecht
MiniMax-Music3 verwendet die MiniMax-Music3 Community License und keine einfache, freizügige Lizenz im Stil von MIT oder Apache. Die Lizenz beinhaltet Bestimmungen zur Namensnennung bei kommerziellen Produkten, eine Umsatzschwelle, die möglicherweise eine zusätzliche Genehmigung erfordert, Sicherheitsanforderungen für gehostete Dienste sowie eine Richtlinie zur akzeptablen Nutzung.
Die Musikgenerierung birgt über die Modelllizenz hinaus auch Risiken in Bezug auf das Urheberrecht und das Rechte-Management. Liedtexte, die Imitation von Künstlerstilen, Stimmähnlichkeiten, Regeln von Distributionsplattformen und Offenlegungspflichten spielen hierbei eine Rolle. Wenn Sie generierte Musik veröffentlichen oder verkaufen möchten, sollten Sie Aufzeichnungen über Prompts, die Inhaberschaft der Liedtexte, die Modellversion und eventuelle Bearbeitungen nach der Generierung aufbewahren.
Prompt-Beispiel
Ein praxisnaher Prompt für MiniMax-Music3 trennt die Liedtexte von der Musikbeschreibung. Für englische Songs schreiben Sie beides auf Englisch. Für andere Sprachen können Sie die Musikbeschreibung dennoch auf Englisch belassen, sofern dies eine stabilere Stilkontrolle ermöglicht.
[Verse] Morning light is breaking through the rain I keep walking past the places we became [Chorus] Hold on, we are brighter than the night Two hearts burning like a signal in the sky Music description: Emotional pop rock, 104 BPM, female lead vocal with airy harmonies, clean electric guitar in the verse, full drums and wide synth pads in the chorus, hopeful but nostalgic, radio-ready modern mix, gradual build to a final anthemic chorus.Für eine effiziente Iteration sollten Sie mit Abschnitten von 30 bis 60 Sekunden beginnen, bevor Sie einen vollständigen Song rendern. Sobald Stimme, Tempo, Instrumentation und die Energie im Refrain stimmen, können Sie die Dauer verlängern. Lange Generierungen sind zeit- und speicherintensiver, weshalb das Testen der Beschreibung wichtig ist.
Häufig gestellte Fragen (FAQ)
Ist MiniMax-Music3 kostenlos?
Die Modellgewichte sind auf Hugging Face verfügbar, aber die lokale Nutzung erfordert dennoch Hardware, Speicherplatz und Einrichtungszeit. Wenn Sie Cloud-GPUs, gehostete Inferenz oder eine API verwenden, können für diese Dienste eigene Kosten anfallen.
Kann MiniMax-Music3 Gesang generieren?
Ja. Das Modell ist darauf ausgelegt, Gesang und instrumentale Begleitung gemeinsam zu erzeugen. Der Charakter des Gesangs wird über die Musikbeschreibung gesteuert und nicht über einen separaten Parameter zur Sprecherauswahl.
Kann es auf einer 8-GB-GPU ausgeführt werden?
Die offizielle Modellkarte gibt an, dass es auf 8-GB-Grafikkarten mit Streaming-Offload passt, jedoch muss mit einer langsameren Generierung gerechnet werden. Für ein reibungsloseres lokales Erlebnis ist eine GPU der 24-GB-Klasse oder ein ComfyUI-Low-VRAM-Workflow realistischer.
Ist es besser als Suno oder Udio?
Nicht für jeden Anwender. Suno und Udio sind für die schnelle Browser-Erstellung unkomplizierter. MiniMax-Music3 ist dann attraktiver, wenn Sie Zugriff auf offene Gewichte, lokale Workflows, ComfyUI-Integration, Reproduzierbarkeit und eine präzisere Steuerung über Beschreibungen wünschen.
Kann ich es kommerziell nutzen?
Möglicherweise, aber Sie müssen die Community-Lizenz sorgfältig prüfen. Die Produktkennzeichnung, das Umsatzvolumen, Sicherheitsvorkehrungen und Rechte Dritter sind dabei von Bedeutung. Der Musikvertrieb bringt zudem urheberrechtliche und plattformpolitische Aspekte mit sich.
Kann es Instrumentalmusik erstellen?
Ja. Verwenden Sie eine klare Beschreibung wie „instrumental cinematic ambient, no vocals“ oder „lofi background music, no vocal lead“ und testen Sie zunächst kürzere Dauern.
Referenzen
- MiniMaxAI/MiniMax-Music3 – Hugging Face
- MiniMax-AI/MiniMax-Music3 – GitHub
- MiniMax Music 3 Demo
- MiniMax Music 3 in ComfyUI
- SGLang-Omni MiniMax Music 3 Kochbuch
- MiniMax-Music3 Community License
Zusammenfassung
MiniMax-Music3 gehört zu den bedeutenderen Veröffentlichungen im Bereich der KI-Musik, da es auf vollständige Songs anstelle von kurzen Clips ausgerichtet ist. Die Unterstützung für Liedtexte, strukturierte Beschreibungen, eine Länge von fünf Minuten, Stereo-WAV-Ausgabe und lokale Workflow-Routen macht es besonders wertvoll für Entwickler und fortgeschrittene Kreative.
Es handelt sich jedoch nicht um eine reibungslose Verbraucheranwendung. Hardwareanforderungen, langsamere Low-VRAM-Modi, Lizenzierung und Urheberrechtsmanagement erfordern Aufmerksamkeit. Für die meisten Leser besteht der beste Weg darin, sich die offizielle Demo anzuhören, kurze Generierungen über ComfyUI oder SGLang-Omni zu testen und erst danach längere Songs oder kommerzielle Workflows in Angriff zu nehmen.
Neueste Bewertungen
Beste Smartbrillen 2026: 6 Modelle für KI, AR und Sport im Vergleich

Cloud-GPU als KI-Workstation: Bilder, Videos, LLMs und NSFW-Grenzen (2026)

Manus 2.0 im Überblick: Studio, Preise, API und Neuerungen
Meta Muse im Test 2026: KI-Agent, Preise und Muse Spark
Wo speichert Spotify Downloads? Kann man sie als MP3 exportieren?
MiniMax H3 Image Studio im Überblick: ComfyUI-Bilder, Bearbeitung und Video