Qwen 3.8 評測:效能、本機部署、GPU 需求與 NSFW 政策

Qwen 3.8 最適合分成兩條線理解:一條是面向大型雲端推理與企業部署的 Qwen3.8-2.4T-A95B / Max 系列,另一條是一般本機 LLM 使用者更有機會實際測試的 Qwen3.8-27B。前者看的是性能上限,後者看的是能不能在自己的工作流程裡用起來。
如果你關心本機部署、GPU 需求、下載地址、商用授權,以及 NSFW 內容上的限制,Qwen 3.8 不能只看跑分。它的不同版本、授權、線上服務和本機權重差異很大,選錯版本會直接影響成本與可用性。
目錄
Qwen 3.8 是什麼
Qwen3.8-2.4T-A95B 是 Max 系列背後的大型開放權重基礎,模型頁面標示 2.4T 參數級別與 qwen3.8-max 授權。
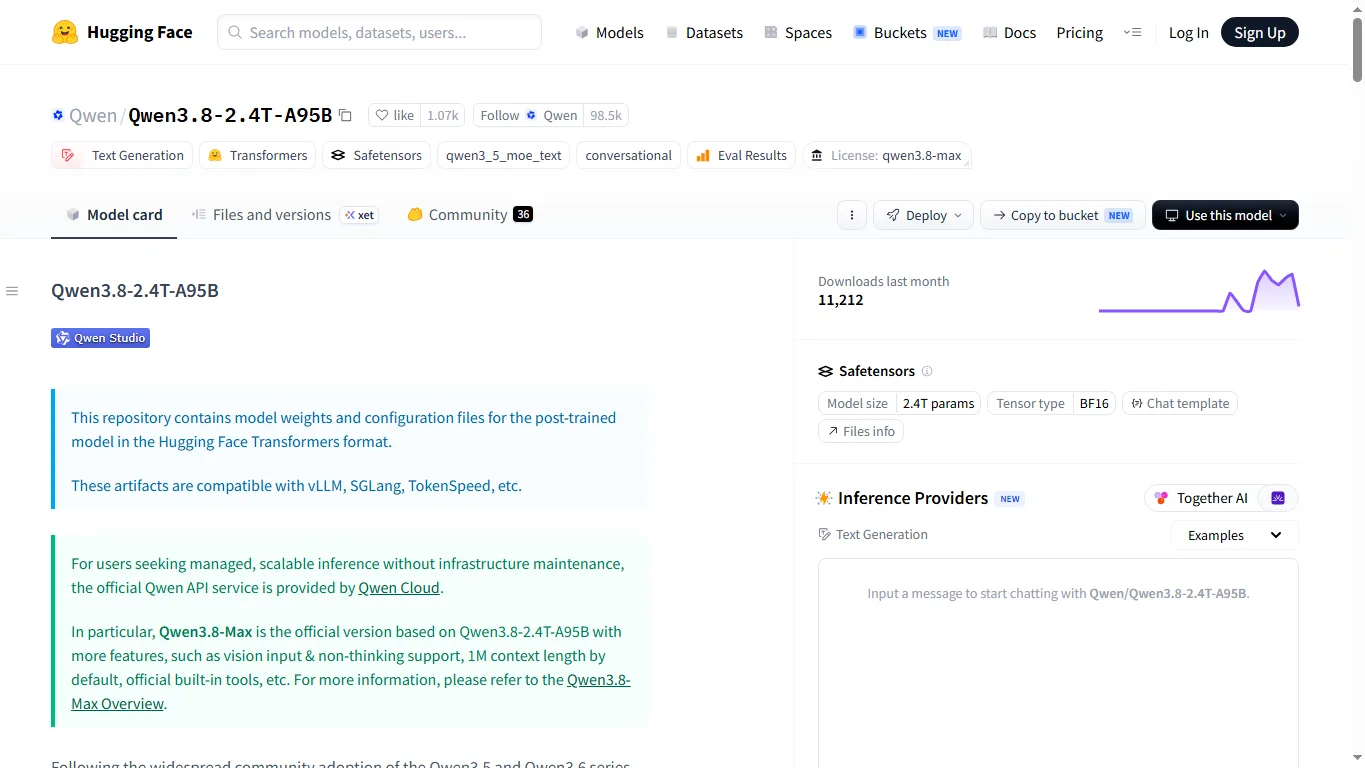
Qwen3.8-27B 則更適合一般本機使用者評估。它在模型頁面上顯示為約 28B 參數、BF16、Apache-2.0,因此在授權與測試門檻上更友善。

模型版本與下載地址
| 模型 | 定位 | 適合用途 |
|---|---|---|
| Qwen3.8-2.4T-A95B | Max / 2.4T | 企業、研究、雲端推理 |
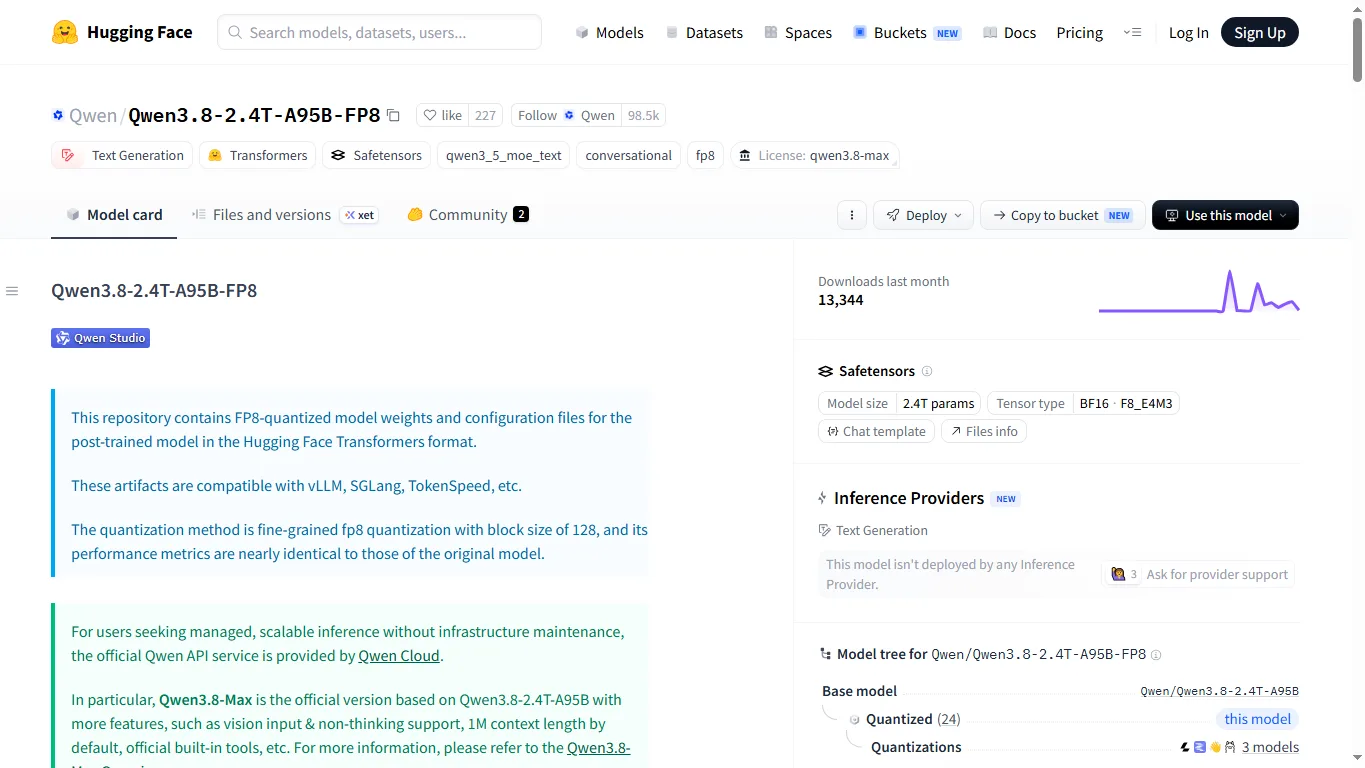
| Qwen3.8-2.4T-A95B-FP8 | FP8 | 降低大型推理記憶體壓力 |
| Qwen3.8-27B | 27B / Apache-2.0 | 本機 LLM、RAG、程式輔助 |
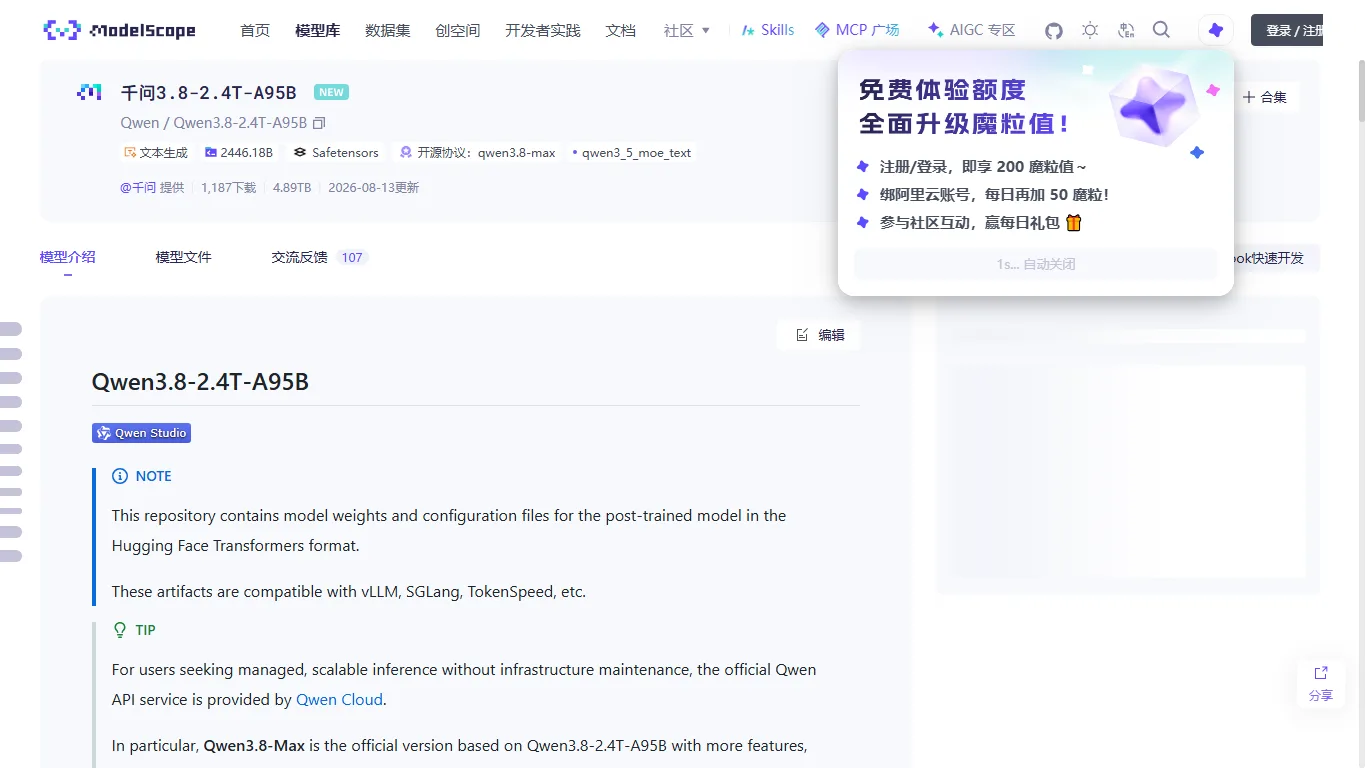
| ModelScope | ModelScope | 中國大陸環境或 ModelScope 使用者 |
效能與實際評價
Qwen 3.8 的亮點在於多語言、程式、長上下文與工具使用能力。社群討論則更關注 27B 是否夠快、量化版是否好用、vLLM/SGLang 支援是否成熟,以及 Max 系列是否值得付出雲端成本。
與主流本機 LLM 比較
| 重點 | 說明 |
|---|---|
| Qwen3.8-27B | 適合日常本機測試、多語言和程式任務。 |
| Llama / Gemma | 生態成熟,小模型更容易跑;Qwen 在亞洲語言和程式任務上很有競爭力。 |
| DeepSeek / Kimi / GLM | 都適合長上下文或推理任務,建議用自己的資料集測試。 |
本機部署方法
建議先從 27B 或量化版開始,不要直接挑戰 2.4T 系列。
安裝指令範例
pip install -U transformers accelerate torch safetensors python - <<'PY' from transformers import AutoModelForCausalLM, AutoTokenizer model_id = "Qwen/Qwen3.8-27B" tok = AutoTokenizer.from_pretrained(model_id, trust_remote_code=True) model = AutoModelForCausalLM.from_pretrained( model_id, torch_dtype="auto", device_map="auto", trust_remote_code=True, ) PYGPU 與 VRAM 需求
| 使用方式 | VRAM | 說明 |
|---|---|---|
| Qwen3.8-27B BF16 | 56GB+ | 80GB GPU 較穩,48GB 長上下文會緊。 |
| Qwen3.8-27B 4bit | 18-24GB+ | RTX 4090 級短中上下文可測。 |
| Qwen3.8-2.4T | Cluster | 不是一般桌機模型,應視為雲端/企業推理。 |
硬體不足時的線上使用方式
Qwen Chat 官方頁面 適合先確認模型風格,再決定是否投入本機部署。線上版也可能提供本機權重沒有的工具、視覺輸入或預設長上下文。
Qwen 3.8-Flash-Next 是什麼
Qwen 也公開了 Qwen3.8-Flash-Next,這是一個預覽 Qwen4 架構方向的 open-weight 實驗模型。它是 125B-A6B 的 MoE 模型,每個 token 實際啟用約 6B 參數,另外還有 51B 參數的 N-gram embedding,設計上可以放在系統 RAM 內預讀,而不是全部塞進 GPU VRAM。
不過,它不是一般遊戲電腦就能輕鬆跑的小模型。官方 BF16 權重大約 360GB,FP8 版本約 185GB,Unsloth 的 GGUF 量化版也落在約 72.5GB 到 111.3GB。比較適合 SGLang、vLLM、TokenSpeed 或 GGUF 工作流程,而不是直接取代一般 27B 本地模型。
它值得被放進 Qwen 3.8 評測裡,是因為它代表 Qwen 接下來的性能方向。Qwen 公布的結果顯示,它在多數語言與視覺語言 benchmark 中超過 Qwen3.8-27B,在 SWE-bench Pro、CoWorkBench、JobBench 等工作型 benchmark 中也有超過 Claude Opus 4.6 Max 的項目。核心新設計包括 GDN + QSA hybrid attention、Gated Residual、RAM 預讀的 N-gram embedding,以及 Muon 訓練方法。
授權方面採用 Qwen Community License 1.0,多數情境可免費商用,但 MaaS、AI coding / office assistant 類產品,以及超大型產品可能需要遵守額外條件或另行簽約。
NSFW 政策與限制
Qwen 官方線上服務並不是無限制 NSFW 聊天工具。露骨性內容、違法用途、危險指示、傷害他人的內容通常會受到政策限制。本機權重在執行層面與線上 UI 不同,但授權、平台規則與當地法律仍然存在。
Qwen3.8-27B Uncensored / Abliterated 版本
如果想在本機環境測試限制較少的派生模型,Hugging Face 上也可以找到 Huihui-Qwen3.8-27B-abliterated。這是基於 Qwen3.8-27B 製作的社群版 uncensored / abliterated 模型,並不是 Qwen 官方發布的版本。一般來說,abliterated 模型會削弱或移除部分拒答傾向,因此面對官方聊天服務或安全對齊模型可能拒絕的提示時,回答意願會更高。
這類模型適合用於本機測試、對齊研究、創作與角色扮演情境的行為比較。不過,因為輸出限制較少,也更容易被引導到成人、危險或法律敏感內容。若要使用,請先閱讀 Hugging Face 模型卡、授權條款、平台規範與所在地法律,尤其不要直接把它當成公開服務部署。
對大多數使用者來說,官方 Qwen3.8-27B 或 Qwen Chat 仍是更穩妥的起點。Abliterated 版比較適合已經熟悉本機模型部署、內容風險與輸出管理的進階使用者。
常見問題
Qwen3.8-Max 和 2.4T-A95B 一樣嗎?
不要完全等同。Max 可視為基於 2.4T-A95B 的官方服務版本,可能包含視覺輸入、工具和長上下文等產品功能。
RTX 4090 可以跑嗎?
27B 的 4bit 量化版有機會在短中上下文測試;BF16 和 2.4T 系列都不適合單張 24GB GPU。
可以商用嗎?
27B 顯示為 Apache-2.0,較適合商用評估;2.4T-A95B 使用 qwen3.8-max 授權,部署前需要閱讀授權條款。
總結
Qwen 3.8 的真正價值在於同時覆蓋大型 Max 服務與較實用的 27B 本機模型。多數讀者應先測 27B 或線上 Qwen Chat,再決定是否投入更重的雲端或分散式推理。
參考資訊
相關 評測
HiDream O1 評測:圖片生成AI、LoRA、本機部署與 NSFW 對應

YuE2-3B 評測:本機 AI 音樂、Suno 比較與 ComfyUI
Wan 3.0 評測:30秒 AI 影片、開源狀態與 NSFW 限制
Illustrious XL 評測|導入、使用方式、LoRA、NSFW、商用利用與 VRAM

ERNIE-Image 評測:開源圖片生成AI、LoRA、本機部署與 NSFW 對應
Gemma 4 評測:本機部署、GPU 需求與 NSFW 政策