YuE2-3B: música local com IA, Suno e ComfyUI
Veja a análise do YuE2-3B: comparação com Suno, instalação local, VRAM, workflow ComfyUI, exemplos de músicas e limites da licença não comercial.

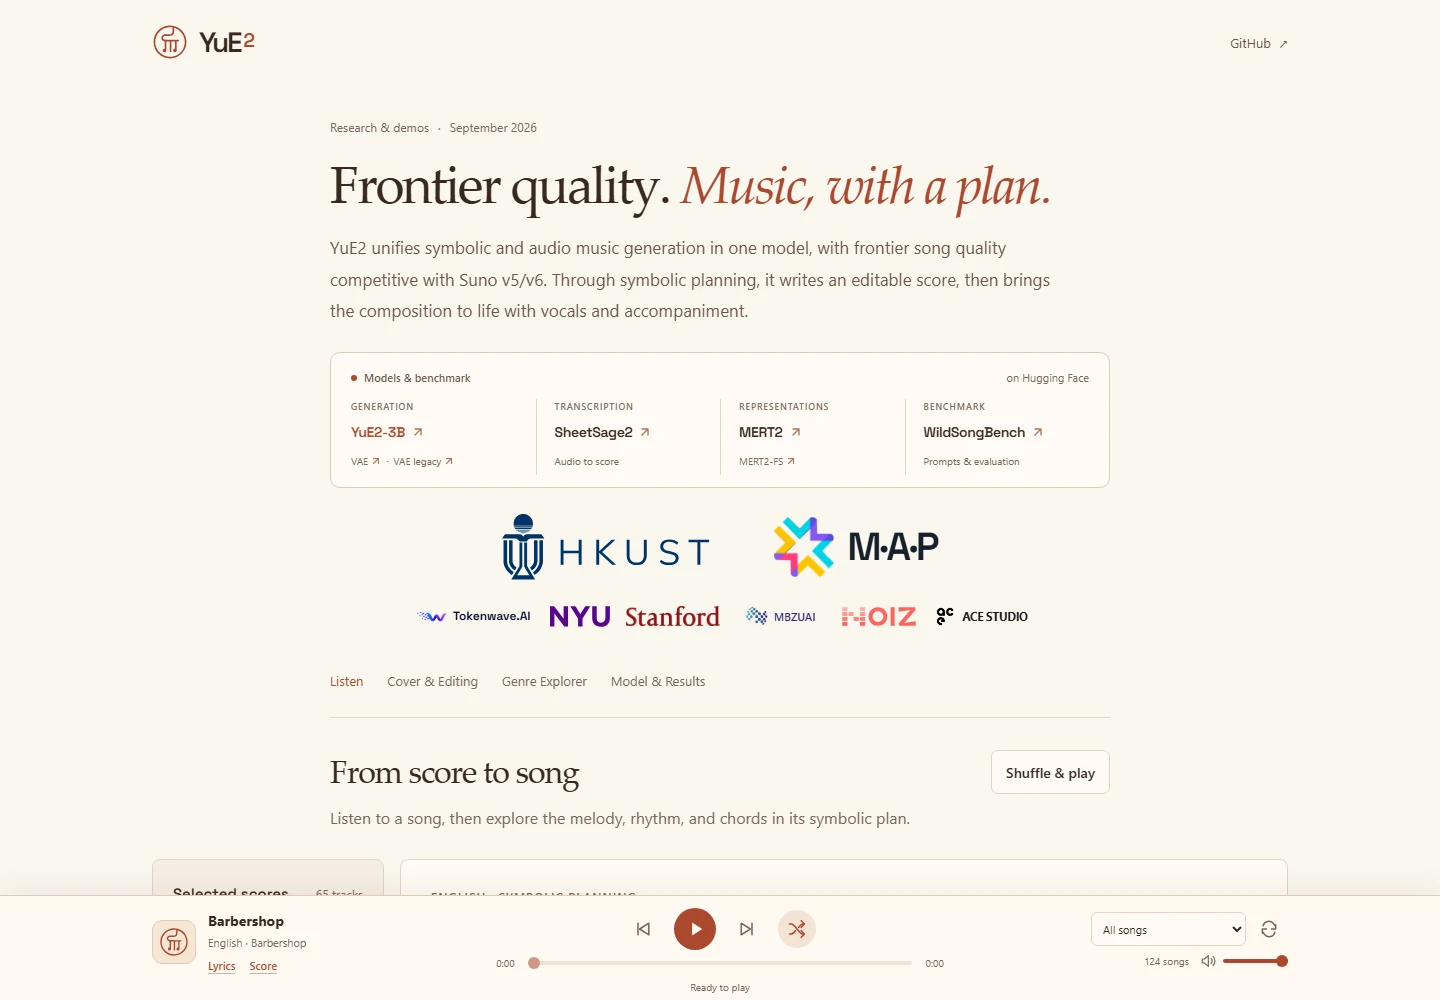
O maior atrativo do YuE2-3B é permitir mexer na composição, em vez de apenas gerar outra música pronta. O modelo transforma letras e descrições de estilo em voz e acompanhamento, expondo uma partitura editável de melodia e acordes. É uma opção interessante para compor por hobby, estudar arranjos e pesquisar geração musical sem fins comerciais.
Isso ainda não faz dele um «Suno grátis» sem restrições. Os pesos têm licença não comercial, a instalação oficial recomenda uma GPU NVIDIA de 24 GB e as opiniões sobre o áudio são divididas. O melhor resultado publicado também seleciona entre oito candidatos. Ouça exemplos antes de investir em hardware.
Atualizado em 16 de setembro de 2026. Análise baseada no modelo lançado, na documentação oficial e em testes identificados da comunidade; não é um benchmark de áudio executado pela AirMore.
O que o YuE2-3B faz e o que mudou
O repositório oficial descreve um modelo da classe 3B que combina planejamento musical e síntese de áudio. Por padrão, ele cria uma partitura ABC com melodia e acordes antes de renderizar áudio estéreo a 48 kHz. Um decodificador separado integra o sistema; o nome 3B não indica todo o consumo de memória.
| Controle | Uso prático |
|---|---|
| cot="full" | Planeja melodia e acordes; opção inicial para novas composições. |
| cot="melody" | Usa a melodia como referência, permitindo mudar o acompanhamento. |
| cot="off" | Gera a partir da letra e do estilo, sem planejamento simbólico. |
| abc=… | Recebe uma partitura ABC própria ou editada nos modos full ou melody. |
ABC é uma notação textual, não uma promessa de leitura de qualquer foto, PDF ou MIDI. O guia de geração explica os formatos e arquivos intermediários. A saída é uma mixagem estéreo; obter faixas isoladas exige separação adicional. O áudio também pode se desviar da partitura planejada.
Em relação ao primeiro YuE, a novidade útil é tornar a composição visível e editável. Porém, editar o ABC gera uma nova gravação completa. Não há garantia de preservar o áudio fora do trecho alterado. Guarde a versão original quando gostar de uma voz ou interpretação específica.
Onde usar online, ouvir e baixar o modelo
| Endereço | O que oferece |
|---|---|
| Demonstração oficial | Músicas, letras, estilos, partituras e exemplos de edição; não é uma assinatura de geração. |
| Modelo oficial no Hugging Face | Pesos e ficha técnica; não equivale a uma API permanentemente disponível. |
| Interface de levibrg | Demo comunitária com Create/Cover, letra, estilo, planejamento, seed e opções MP3/FLAC. |
| Space de mrfakename | Hospedagem comunitária sujeita a disponibilidade e cota ZeroGPU; indisponível em 16 de setembro. |
| WebUI do audio.cpp | Interface no navegador depois de instalar o runtime e os pesos no próprio computador. |
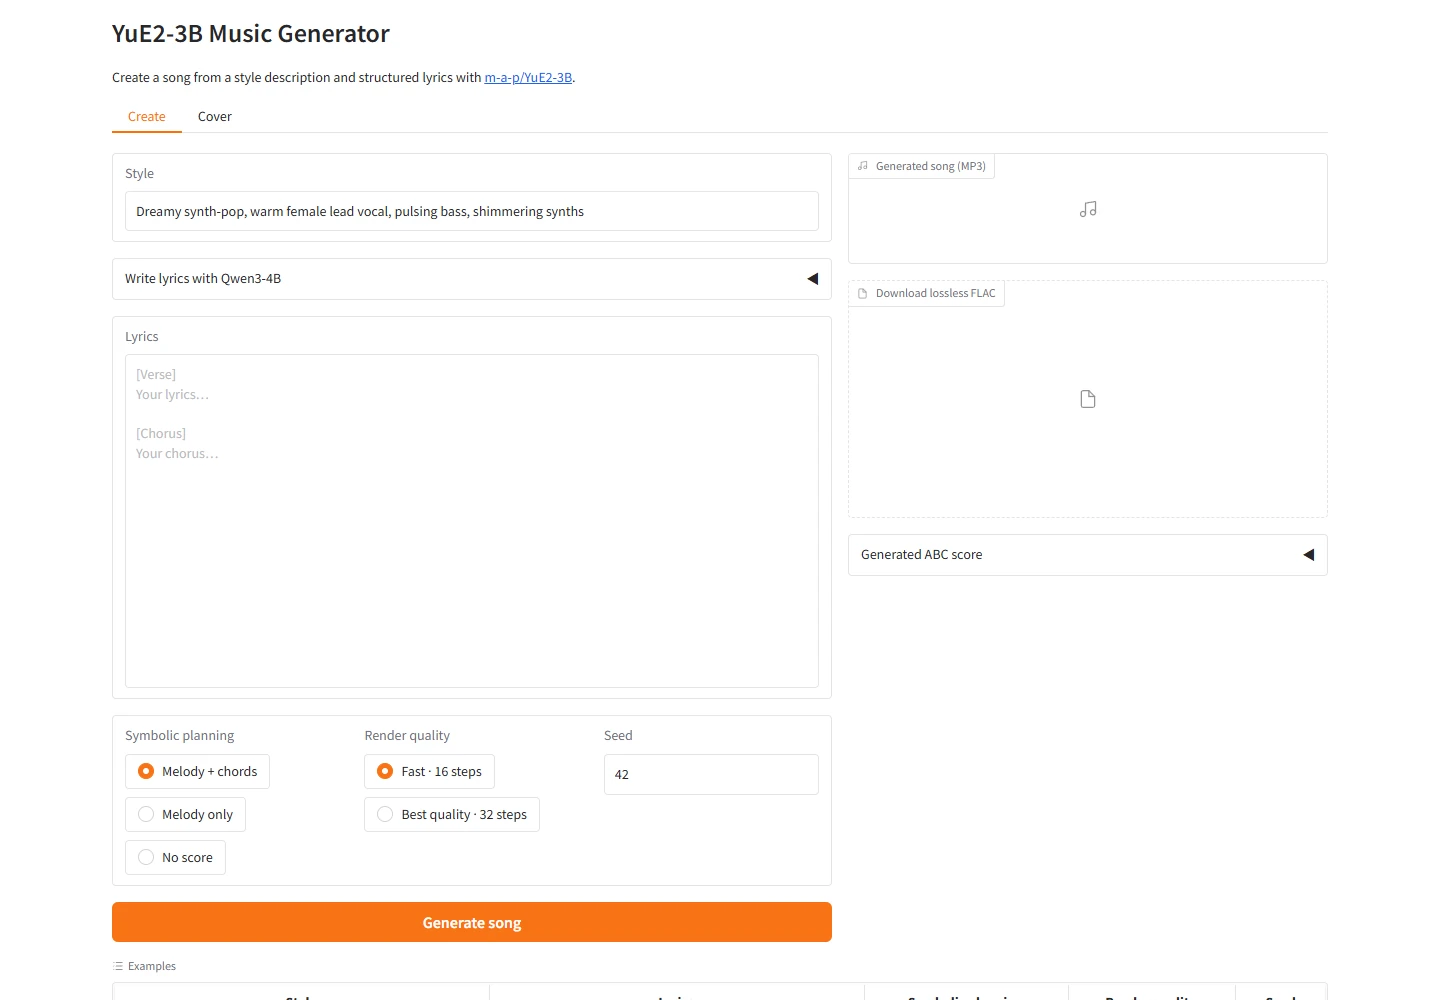
A interface de levibrg estava acessível em 16 de setembro, mas isso não comprova geração bem-sucedida nem cota de GPU disponível. Os Spaces não são uma API oficial da M·A·P nem um serviço grátis com disponibilidade garantida. Ter YuE2 no domínio também não identifica o desenvolvedor oficial.
Comece com uma estrofe e um refrão originais, idioma explícito e uma descrição objetiva de instrumentos e clima. Salve prompt, seed e partitura juntos. Confira o tratamento dos arquivos antes de enviar gravações privadas para demonstrações públicas.
Ele alcança o Suno? Entenda o Best-of-8
O WildSongBench oficial usa 192 prompts e avaliação automática, não uma audição cega independente. SongBench Avg favorece valores maiores; PER representa a taxa de erro de fonemas e deve ser menor.
| Modelo / configuração | SongBench Avg ↑ | PER ↓ |
|---|---|---|
| YuE2, best-of-8 | 6.9632 | 9.79% |
| Suno v5 | 6.8721 | 8.10% |
| YuE2, padrão / 2 candidatos | 6.7316 | 8.44% |
| Suno v6 | 6.5562 | — |
| MiniMax Music 3 | 6.2830 | 6.27% |
| ACE-Step 1.5 | 6.0118 | 7.46% |
| YuE 1 | 4.9165 | 36.38% |
O resultado padrão do YuE2 já seleciona entre dois candidatos. Best-of-8 seleciona entre oito. Uma chamada normal do pipeline produz um candidato; escolher o melhor é uma etapa separada. Portanto, chamar a linha padrão de Best-of-1 é incorreto. Oito gerações também custam mais processamento e tempo de audição.
Os dois resultados de YuE2 usam YuE2-Vae-legacy, enquanto o decodificador habitual para ouvir é YuE2-Vae. O projeto descreve diferenças entre musicalidade medida e qualidade percebida. Compare decodificador, prompts, quantidade de candidatos e parâmetros antes de tirar conclusões.
A tabela indica competitividade nesse protocolo, não superioridade universal em voz, guitarra e arranjo. Uma nota menor de uma versão comercial mais recente tampouco significa piora em todas as situações.
O que usuários realmente relatam
O teste de kun432 no Zenn inclui instalação em Colab L4, registros de execução e links de áudio. Naquele ambiente, o autor relata cerca de quatro minutos de geração e pico de aproximadamente 9 GB de VRAM. Há erros de leitura/pronúncia em japonês; ele diz não ter usado Suno, portanto não é um comparativo direto com Suno.
As notas de asfdrwe no Qiita registram Fedora 44, Radeon RX 7800 XT e audio.cpp Q4, com compilação HIP e um exemplo de pop japonês. Isso documenta uma combinação AMD específica, não suporte oficial a qualquer Radeon. O texto também registra mudanças nas opções de carregamento.
No debate inicial do Reddit, GreyScope relata execução em uma 4090; martinerous percebe ruído granular, chamado de «AI sand», e Sindre_Lovvold critica guitarras de rock/metal e fidelidade ao estilo. Uma discussão posterior sobre covers traz experiências muito positivas. São relatos individuais com configurações e seleção diferentes, não uma taxa de sucesso representativa.
Preste atenção em vogais longas, consoantes, ataques de guitarra, caudas de pratos, transições e finais. Para trilha de fundo, procure vozes indesejadas; em canções, confira cada verso. Um trecho convincente de metais não garante quatro minutos de arranjo estável. As evidências concretas vêm principalmente de desenvolvedores e usuários; ainda não há consenso sólido de grandes veículos a partir de testes independentes de audição.
Hardware, VRAM e velocidade de geração
| Caminho | Dados publicados | Como interpretar |
|---|---|---|
| PyTorch oficial, BF16 | Linux, Python 3.12, NVIDIA com BF16; recomendação de 24 GB de VRAM e 24 GB de RAM. | Configuração de referência, não consumo obrigatório de toda a VRAM. |
| Teste oficial na RTX 4090 | full: 214,85 s de áudio em 71,04 s; pico de 11,18 GiB. | Medição após aquecimento, sem primeira instalação ou download. |
| Contexto maior | Pico oficial de 14,08 GiB. | Deixe espaço para decodificador e outros aplicativos. |
| GGUF comunitário | Q8/Q4, VAE, configuração e tokenizador separados. | Outro runtime, com instruções próprias. |
A ficha oficial informa aproximadamente 7,8 GB de pesos para o modelo e VAE padrão. Como margem de planejamento, reserve 20–30 GB livres em SSD e considere 32 GB de RAM para uma máquina nova; isso não é um mínimo oficial.
| Configuração audio.cpp | Áudio gerado | Tempo | Pico de VRAM |
|---|---|---|---|
| BF16 + F32 VAE | 224.96 s | 60.46 s | 12,535 MiB |
| Q8_0 + F16 VAE | 194.84 s | 38.81 s | 8,867 MiB |
| Q4_0 + F16 VAE | 221.12 s | 44.15 s | 7,755 MiB |
As medições do mantenedor do audio.cpp usam uma RTX 5090, após aquecimento. Os áudios têm durações diferentes, portanto não são gravações idênticas. Um pico Q4 de 7.755 MiB nessa GPU não garante execução em qualquer placa de 8 GB.
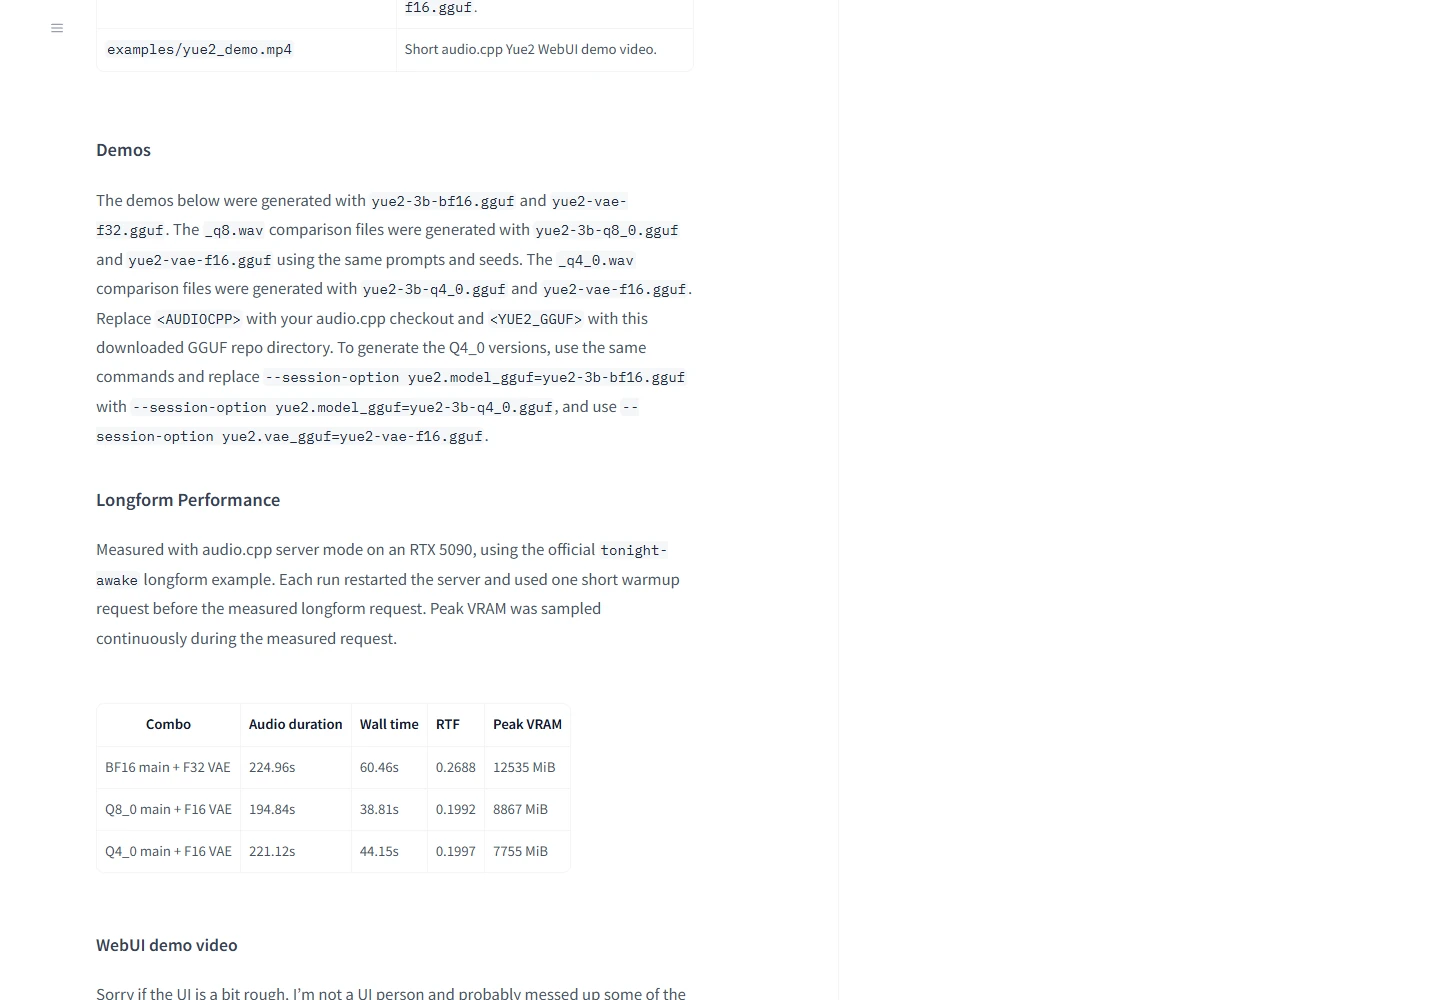
Quem já tem uma GPU adequada não paga créditos por faixa gerada localmente. Para uso ocasional, comprar um computador só para isso exige considerar equipamento, energia, manutenção e tentativas descartadas. Pesos gratuitos não tornam oito gerações gratuitas em termos de processamento.
Como instalar localmente: Python e GGUF
Instalação oficial em Linux e NVIDIA
Siga o início rápido oficial em um ambiente limpo de Python 3.12. Os comandos vêm da documentação; não representam testes da AirMore em todas as GPUs.
git clone https://github.com/multimodal-art-projection/YuE.git cd YuE python3.12 -m venv .venv source .venv/bin/activate python -m pip install --upgrade pip python -m pip install . python examples/generate.py --output outputs/first-songA primeira execução baixa os pesos. Ouça outputs/first-song/audio.flac e guarde a pasta completa. Salve o exemplo original em inglês abaixo como my_song.py e execute python my_song.py. Substitua letra e idioma conforme necessário, testando frases curtas primeiro.
from yue2 import YuE2Pipeline with YuE2Pipeline.from_pretrained("m-a-p/YuE2-3B", device="cuda") as pipe: song = pipe( style="English, warm piano pop, 96 BPM, clear lead vocal, " "soft drums, restrained verse, wider final chorus", lyrics="[Verse]\nThe station lights are fading slow\n" "I keep a little hope to go\n\n" "[Chorus]\nOne more morning, one more mile\n" "Carry me home with a quiet smile", cot="full", seed=42, ) song.save_artifacts("outputs/my-song") print(song.truncated)Confira song.truncated e result.json: um áudio reproduzível pode ter atingido o limite de tokens. Guarde partitura, parâmetros e revisões do modelo/VAE. Consulte os guias de edição e transcrição com SheetSage2 seguida de cover. A geração comum a partir de texto não exige MERT2.
audio.cpp, Windows e AMD
O audio.cpp v0.8.0, de 15 de setembro, integra YuE2 e SheetSage2 à branch main; tutoriais antigos exigindo dev ficaram desatualizados. Obtenha no pacote GGUF o modelo, VAE e arquivos auxiliares de configuração/tokenizador. Apenas o arquivo principal não basta.
Use as opções atuais de carregamento da CLI ou WebUI. Pacotes CUDA para Windows precisam do runtime correspondente; usuários AMD devem seguir as notas de HIP/ROCm. Separe falta de arquivos, kernels incompatíveis, conflitos de Torch e falta de memória. Mantenha o ambiente Python oficial separado do ComfyUI e comece com uma música curta.
Workflow do ComfyUI: partitura até áudio
O FL YuE2 para ComfyUI oferece piano roll e geração em etapas. O mantenedor valida Windows, Python 3.12, Torch 2.11 e RTX PRO 6000 Blackwell; outros dispositivos e configurações de 24 GB não foram validados nessa integração. Não trate a recomendação oficial de Python como garantia para todos os nós.
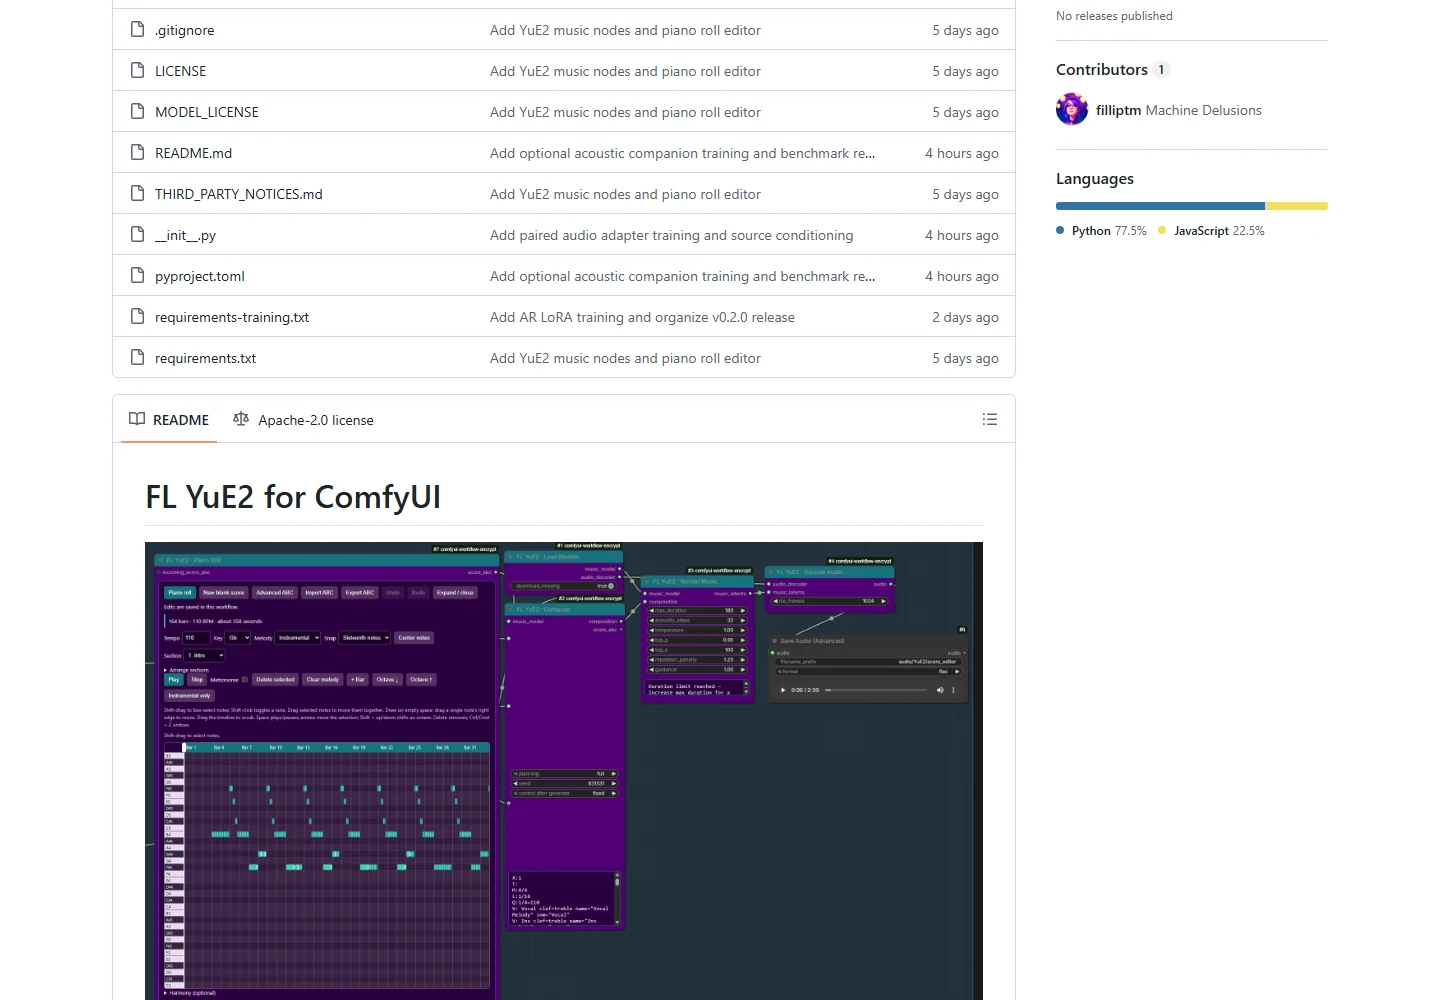
Baixe score_editor_to_song.json ou o JSON original. Instale os nós pelo ComfyUI Manager, ou use os comandos abaixo com o interpretador Python do ComfyUI, e reinicie. Na versão portátil, use o Python embutido.
cd ComfyUI/custom_nodes git clone https://github.com/filliptm/ComfyUI-FL-YuE2.git cd ComfyUI-FL-YuE2 python -m pip install -r requirements.txt- Arraste o JSON para o ComfyUI e instale os nós ausentes.
- Load Models baixa cerca de 7,8 GB em ComfyUI/models/yue2/ no primeiro carregamento.
- Edite notas e acordes no Piano Roll Score Editor; o exemplo tem oito compassos.
- Siga as conexões da partitura até planejamento e geração; preserve os resultados intermediários aceitos.
- O exemplo usa 32 passos e um teto de 45 segundos de áudio. Comece por essa geração curta.
- Ouça com PreviewAudio e salve com SaveAudio, guardando também workflow e seed.
Concluir a execução não garante qualidade musical. Confira letra, ruído e transições antes de aumentar a duração. Se o carregamento falhar, examine nós, arquivos e memória antes de trocar todos os parâmetros.
Mantenha primeiro a partitura instrumental de oito compassos. Para uma música nova, desconecte a entrada da partitura, preencha estilo e letra em Compose e mantenha full. A cadeia é Piano Roll → Compose → Render Music → Decode Audio → Preview/Save, com carregador compartilhado. Para instrumental, deixe a letra vazia. Os arquivos vão para output/audio/YuE2/; 45 segundos é um teto, não uma duração exata. Reduzir tile_frames pode poupar memória do decodificador, mas não resolve toda falta de memória. SheetSage2 exige um ambiente anterior separado neste pack; não misture arquivos e configurações dos nós nativos com os de FL.
Exemplos de músicas para ouvir e comparar
| Exemplo | O que avaliar |
|---|---|
| Músicas e edições oficiais | Correspondência entre letra, estilo, partitura e som. |
| The Last Train em 14 versões | Preservação da melodia ao mudar o arranjo. |
| Música original japonesa de kun432 | Pronúncia, vogais e versos omitidos. |
| Cover japonês de kun432 | Variação de voz e acompanhamento; consulte também o Zenn. |
| Áudios BF16/Q8/Q4 | Ruído e detalhes instrumentais após quantização. |
Players externos podem pedir acesso ou verificação. Os links levam às publicações originais, sem cópias hospedadas aqui. Ouça a música inteira com fones e depois em caixas, em volumes semelhantes; o refrão sozinho não basta.
Comparação com Suno, MiniMax Music 3 e ACE-Step
Suno: praticidade, assinatura e limites
As notas de versão do Suno de 9 de setembro incluem v6, v6 wild e v6 mini. O v5 do benchmark é uma referência específica, não toda a oferta atual. Suno favorece quem quer gerar sem instalar; YuE2 favorece controle local da composição.
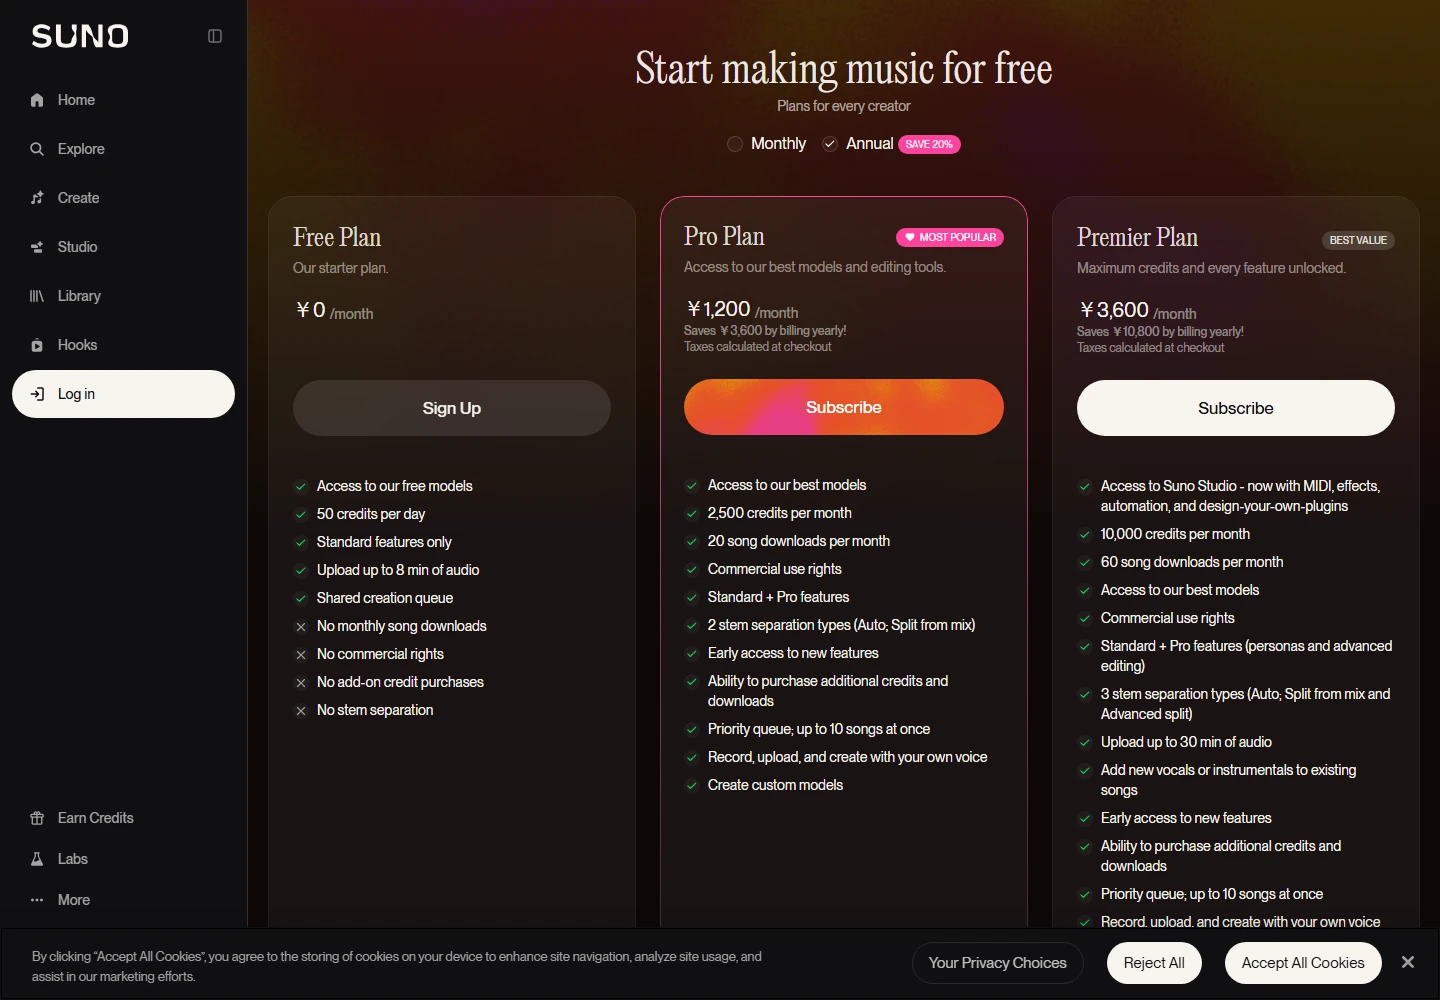
O preço de referência dos EUA equivale a US$8/mês no Pro e US$24/mês no Premier com cobrança anual. Não é o preço de pagamento mensal nem uma cotação em reais ou euros. Confira moeda, impostos e período na sua conta; a captura em ienes não representa uma oferta local em português.
A regra de downloads de 3 de setembro prevê sete downloads de teste durante toda a vida de uma conta grátis; Pro e Premier têm 20 e 60 por mês, com exceção para o fluxo Studio. Streaming e compartilhamento por link continuam disponíveis. Não é correto dizer que usuários grátis nunca podem baixar. Créditos, downloads e direitos comerciais são limites diferentes.
MiniMax Music 3: arquitetura e licença próprias
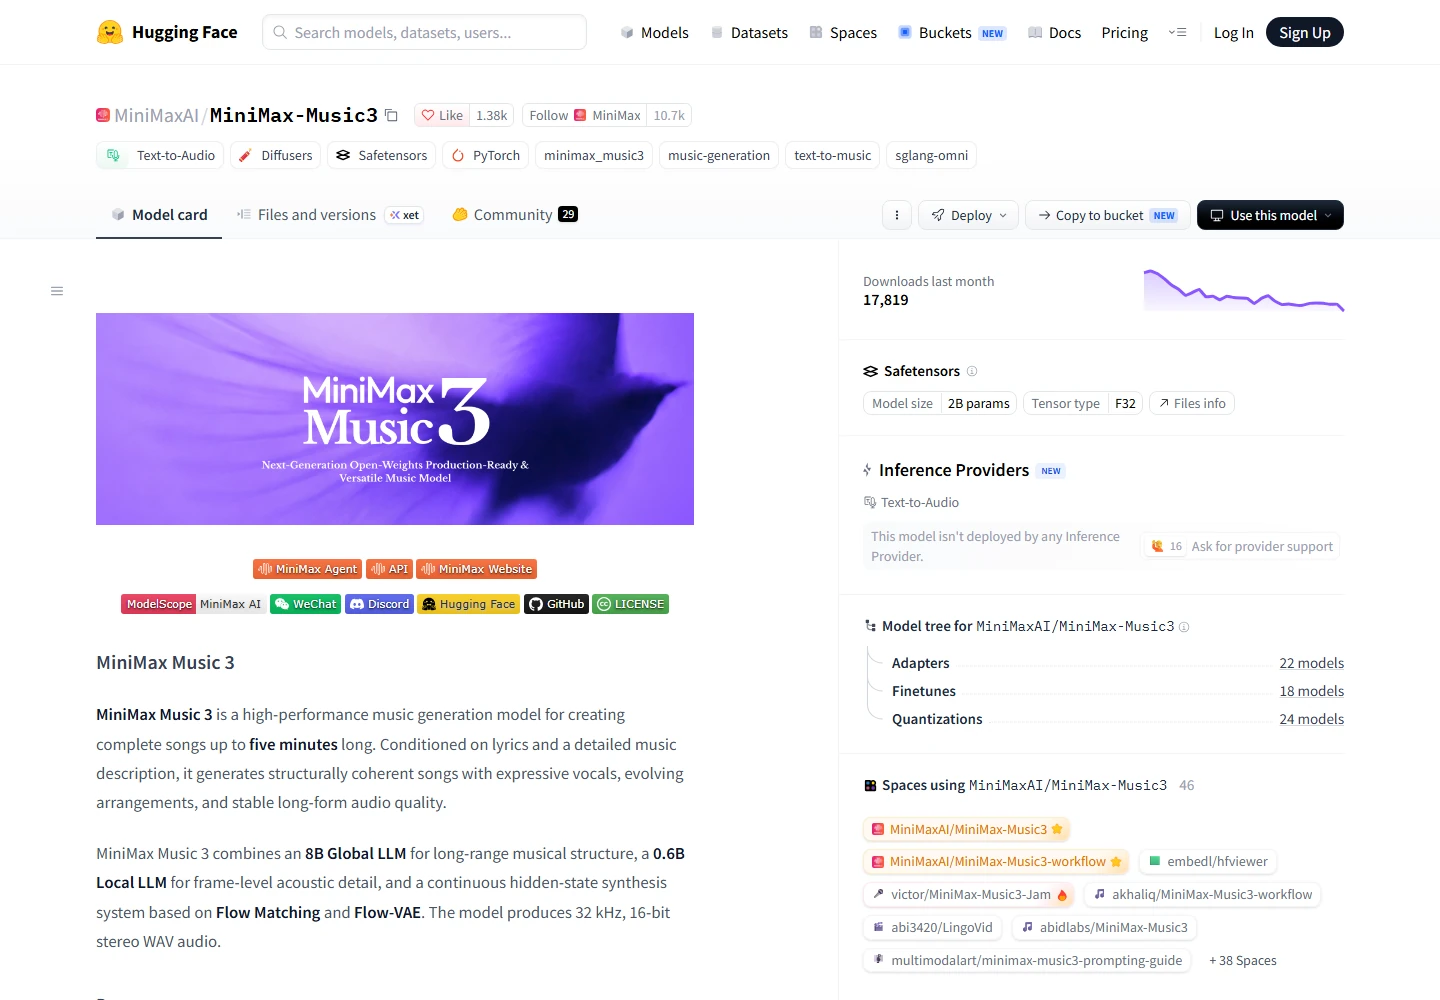
O MiniMax Music 3 combina um modelo global de 8B, um local de 0,6B e outros componentes de síntese, produzindo até cinco minutos de áudio estéreo a 32 kHz. O núcleo do YuE2 é menor, mas parâmetros não determinam sozinhos VRAM e qualidade percebida.
Há um Space oficial. A Music3 Community License inclui condições de nome/atribuição, salvaguardas e autorização adicional para receitas anuais abrangidas acima de US$20 milhões. Não aplique a licença do YuE2 ao MiniMax, nem o contrário.
ACE-Step: revisões locais e flexibilidade
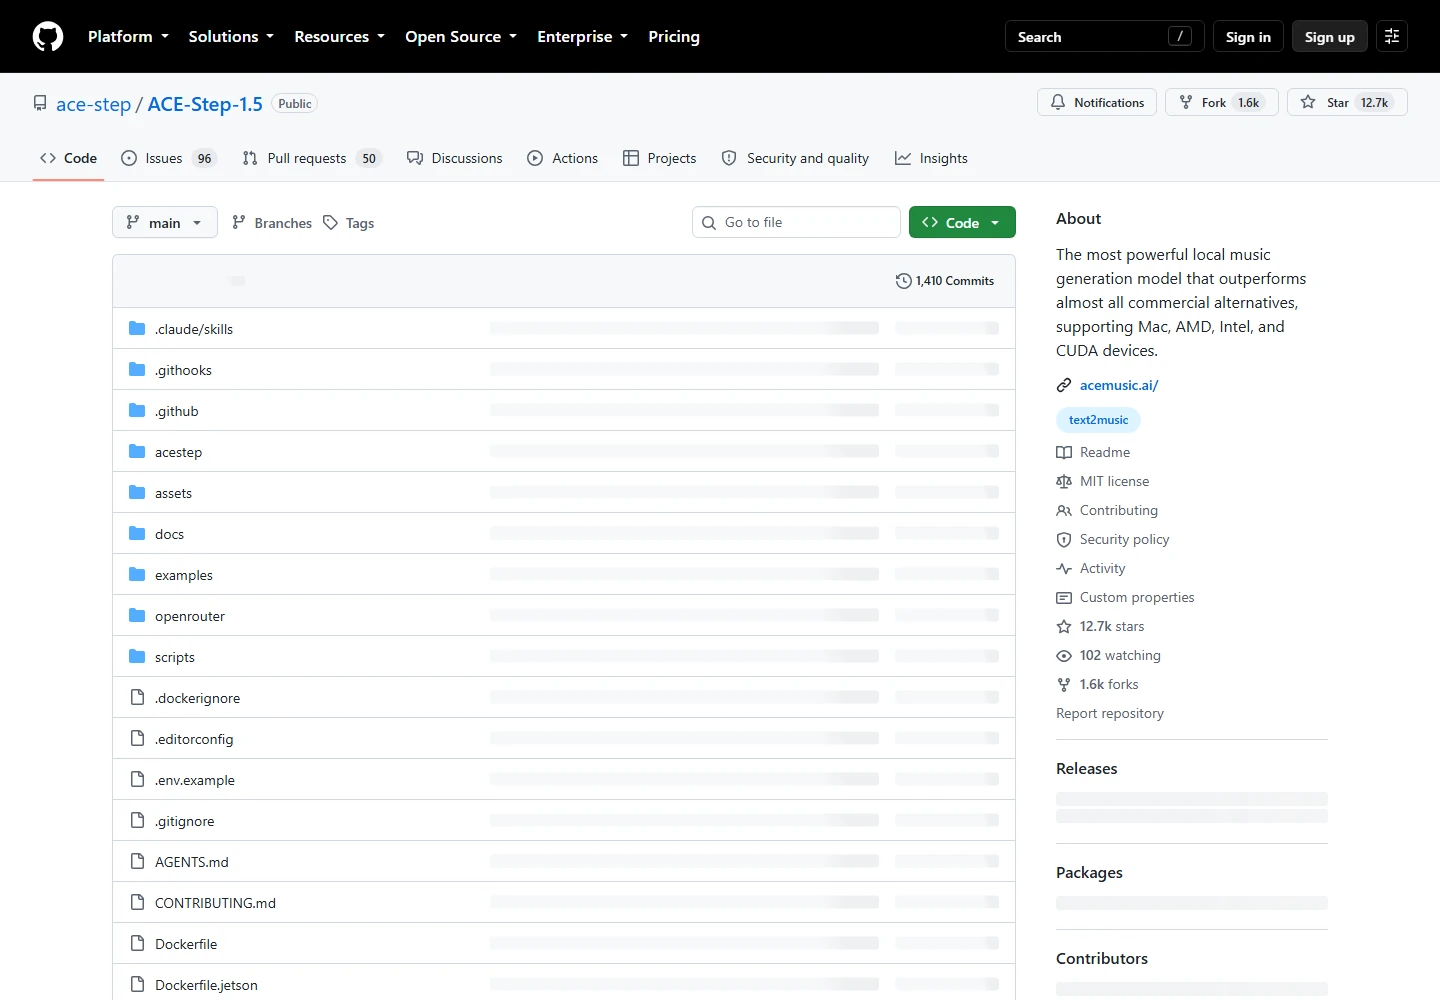
O ACE-Step 1.5, sob MIT, oferece geração, covers e repintura. A documentação distingue cerca de 4 GB para DiT sozinho e pelo menos 6 GB para LM mais DiT. As variantes XL recentes usam um DiT de 4B, indicando ao menos 12 GB com offloading/quantização e 20 GB recomendados. O mínimo da menor configuração não vale para XL.
Escolha YuE2 pelo estágio de composição editável; compare ACE-Step para revisões locais e serviços hospedados para economizar instalação. Em projetos comerciais, a licença precisa pesar tanto quanto o som.
Perguntas frequentes
É totalmente aberto e gratuito para uso comercial?
Código e documentação próprios usam Apache 2.0, mas os pesos usam CC BY-NC 4.0. Arquivos antigos mantêm a licença incluída. Download disponível não autoriza automaticamente serviços pagos ou trabalhos para clientes.
Roda em uma GPU de 8 GB?
O consumo Q4 medido se aproxima disso, mas o teste usou uma 5090. É uma oportunidade de experimentar no equipamento existente, não uma garantia de compra. A rota oficial recomenda 24 GB NVIDIA.
Canta bem em português ou japonês?
Existem exemplos japoneses com erros relatados; isso não prova precisão em português. Teste linhas curtas, conferindo vogais, consoantes e palavras omitidas antes de tentar uma faixa longa.
Editar a partitura preserva a voz e o restante da música?
Não há essa garantia. A partitura controla a composição, mas a síntese cria outra gravação. Timbre, tempo e acompanhamento podem mudar; salve as tomadas preferidas.
Por que meu primeiro resultado soa pior que a demo?
Seleção, gênero, prompt, decodificador e parâmetros podem ser diferentes. Inclua os resultados ruins na avaliação. Best-of-8 não promete a mesma qualidade numa única chamada.
Há suporte a NSFW ou letras explícitas?
O lançamento não garante suporte universal a NSFW. Rodar localmente não demonstra um «modo sem censura», e demos podem ter regras próprias. Considere esse comportamento não verificado.
Veredito: experimente pela composição, com expectativas realistas
O YuE2 torna melodia e harmonia inspecionáveis antes de finalizar o áudio. Isso agrega valor para composição não comercial, estudo de arranjos e pesquisa. Os exemplos justificam uma tentativa, mas ainda exigem seleção faixa a faixa.
Para lançamento comercial, voz limpa na primeira tentativa ou uso de um clique, não é a recomendação automática. Ouça seu estilo, teste um trecho no hardware que já possui e avance para ComfyUI quando o resultado atender ao objetivo.
Relacionados Avaliações
Review do Kimi K3: MoE open-weight 2.8T, uso local, benchmarks e NSFW

Análise do GPT-6 Astra: preços, API, experiências e limites

Review do Gemini Omni 1.1 Flash: IA de vídeo do Google, 4K, API e limites NSFW

Review do GLM-5.3-Flash: Ox-Alpha, API, benchmarks e limites NSFW
Review do NovelAI V5: NSFW, prompts, preço e limites
Claude Fable 5.1 e Mythos 5.1: análise 2026, preços, API, NSFW e comparação com GPT e Gemini