Dolphin 3.0 im Test: Unzensiertes, lokales LLM für NSFW, Rollenspiele und Programmierung
Dolphin 3.0 ist einer der bekanntesten Namen in der Welt der unzensierten lokalen LLMs. Es ist nicht einfach nur ein weiteres Benchmark-Modell: Nutzer suchen gezielt…

Dolphin 3.0 ist einer der bekanntesten Namen in der Welt der unzensierten lokalen LLMs. Es ist nicht einfach nur ein weiteres Benchmark-Modell: Nutzer suchen gezielt nach Dolphin, wenn sie ein Modell wünschen, das System-Prompts bereitwilliger befolgt, beim Schreiben und Rollenspielen flexibler ist und weniger gefiltert agiert als gängige Cloud-Assistenten.
Die praktische Zusammenfassung lautet: Dolphin 3.0 R1 Mistral 24B ist die stärkere Flaggschiff-Option, sofern genügend GPU-Speicher vorhanden ist, während Dolphin 3.0 Llama 3.1 8B das unkompliziertere Desktop-Modell für Ollama, LM Studio und schnelle lokale Experimente darstellt. Es eignet sich hervorragend für kreatives Schreiben, Rollenspiele, Programmierung, Mathematik und agentenbasierte lokale Workflows. Für eine öffentliche Bereitstellung sind jedoch nach wie vor eigene Sicherheitsrichtlinien erforderlich.
Inhalt
Was ist Dolphin 3.0?
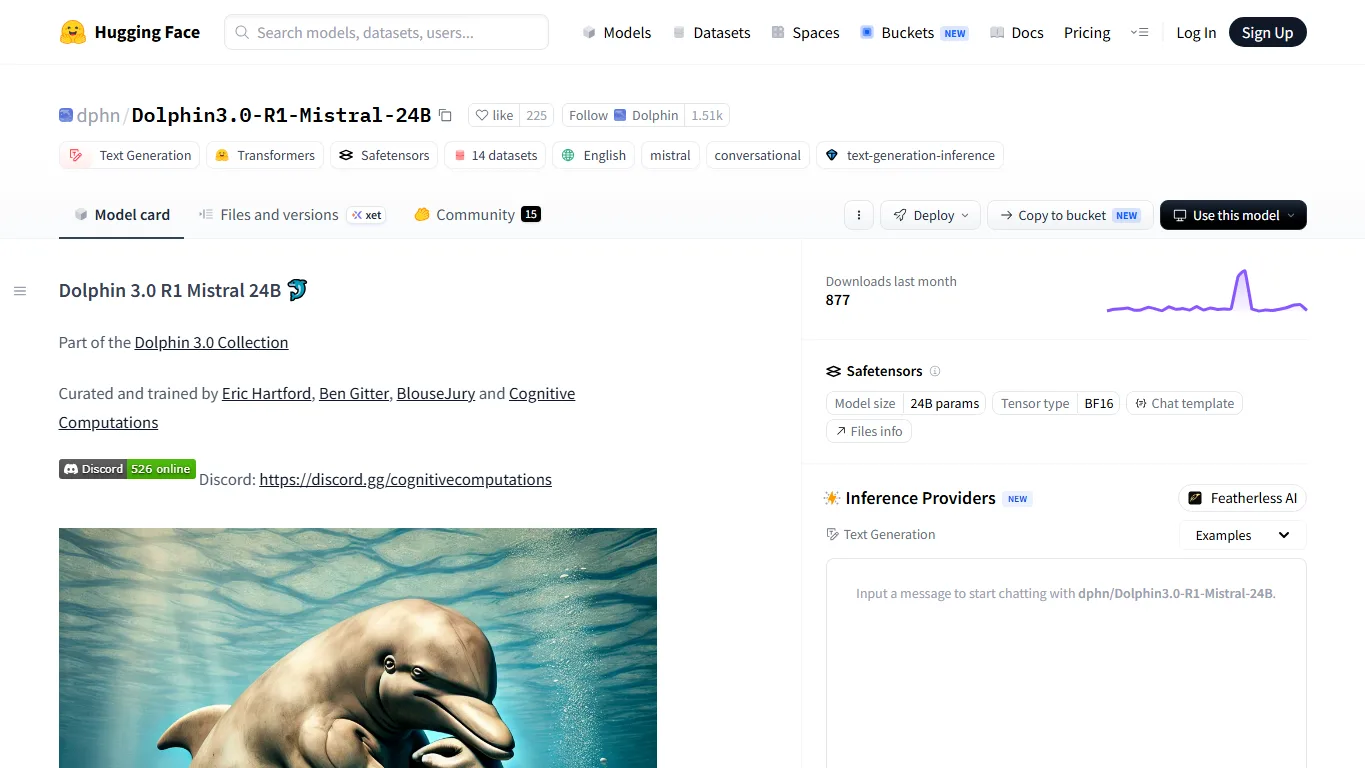
Dolphin 3.0 ist eine Familie instruktionstingierter lokaler Modelle, die von Eric Hartford, Ben Gitter, BlouseJury und Cognitive Computations kuratiert wurde. Die Modellkarte für Dolphin3.0-R1-Mistral-24B beschreibt es als universelles lokales Modell für Programmierung, Mathematik, Agentenaufgaben, Funktionsaufrufe (Function Calling) und allgemeine Chat-Anwendungen. Dabei wird auch die Philosophie hinter Dolphin deutlich: Nicht der Herausgeber des Modells, sondern der Betreiber des Systems sollte über System-Prompts und Ausrichtungsrichtlinien entscheiden.
Genau diese Philosophie sorgt dafür, dass Dolphin in der lokalen Community nach wie vor sehr beliebt ist. Es wird häufig von Anwendern gewählt, die herkömmliche, auf Sicherheit ausgerichtete Assistenten als zu einschränkend für Fiktion, private Rollenspiele, lokale Experimente oder die Erforschung von Prompt-Verhalten empfinden. Gleichzeitig bleibt Dolphin letztlich ein Sprachmodell: Es kann halluzinieren, schlechte Prompts übernehmen und Inhalte erzeugen, die ohne Moderation für öffentliche Produkte ungeeignet sind.
Offizielle Downloads
| Modell | Ideal für | Download |
|---|---|---|
| Dolphin 3.0 R1 Mistral 24B | Beste Gesamtqualität in der klassischen Dolphin-3.0-Reihe; Programmierung, Mathematik, Rollenspiele und Agentenaufgaben | Hugging Face 24B |
| Dolphin 3.0 Llama 3.1 8B | Tests auf Consumer-GPUs, lokaler Desktop-Chat, schnelle Rollenspiele und Schreibaufgaben | Hugging Face 8B |
| Dolphin 3.0 Llama 3.1 8B GGUF | Nutzung via llama.cpp, LM Studio, KoboldCPP oder im Ollama-Stil | Offizielles GGUF 8B |
| Dolphin 3.0 R1 Mistral 24B GGUF | Quantisierte 24B-Tests für Desktop und Server | Bartowski GGUF 24B |
| Ollama dolphin3 | Schnelle lokale Einrichtung für die 8B-Version mit nur einem Befehl | Ollama dolphin3 |
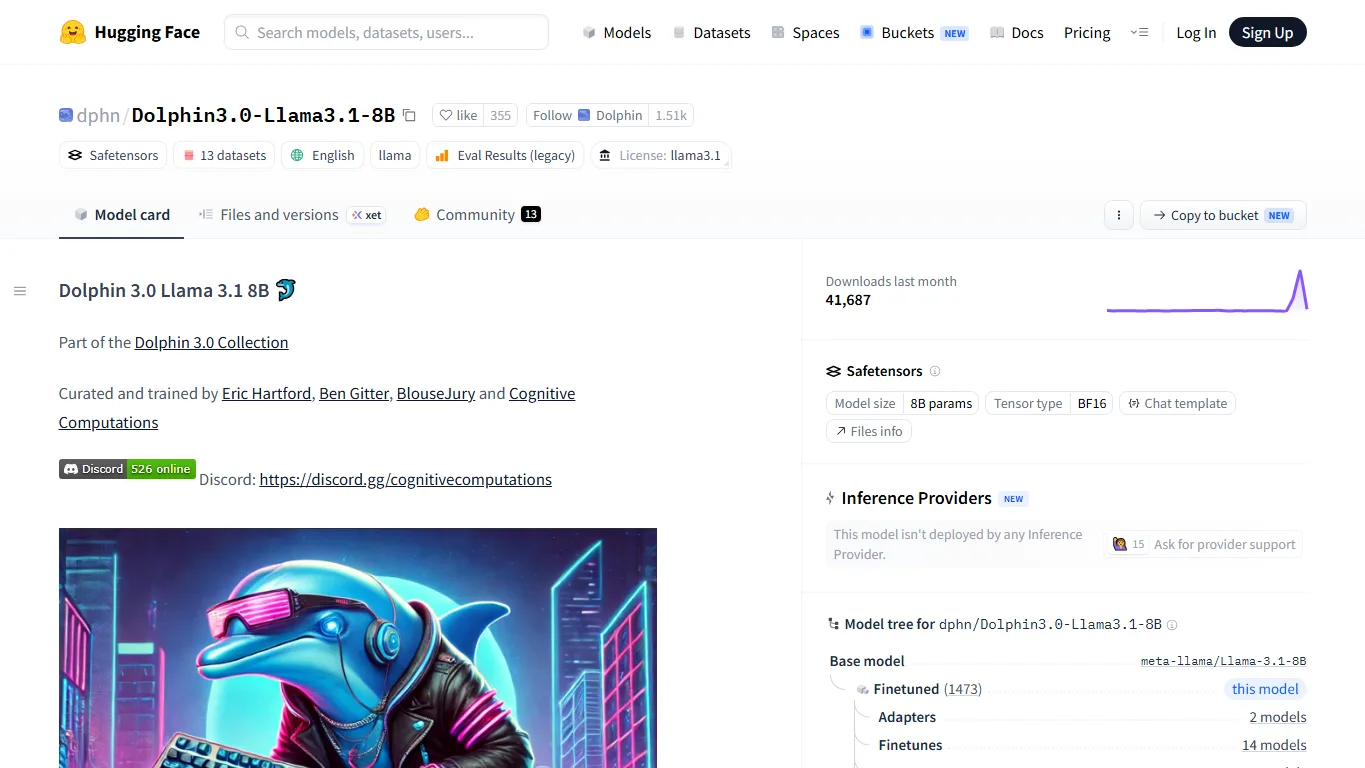
Wer neu bei Dolphin ist, sollte mit der 8B-Version oder Ollama beginnen. Der Wechsel zum 24B-Modell empfiehlt sich, sobald Prompts, Kontextlänge und Hardwareressourcen genau bekannt sind. Das 24B-Modell ist zwar das interessantere Testobjekt, aber die 8B-Variante lässt sich von den meisten Anwendern ohne Anpassungen an der bestehenden Workstation betreiben.
Nutzereindrücke und Stärken
Das Interesse der Community an Dolphin dreht sich meist um drei wesentliche Stärken: exakte Befehlsbefolgung, Stabilität beim Schreiben und in Rollenspielen sowie deutlich weniger Verweigerungen (Refusals). Das Modell versucht nicht, der sicherste Alltagsassistent zu sein, sondern ein kontrollierbares lokales Modell, bei dem der Nutzer das Verhalten über den System-Prompt selbst definiert.
Verglichen mit vielen offiziellen Chat-Modellen wirkt Dolphin oft direkter und weniger bevormundend. Das macht es besonders wertvoll für das Verfassen von fiktionalen Texten, Charakterdialogen, privates Brainstorming, lokale Agenten und Programmierassistenten, bei denen eine konsequente Umsetzung von Anweisungen gefragt ist. Der Nachteil dabei: Es erfordert mehr Disziplin seitens des Anwenders. Ist der Prompt unpräzise, fällt auch das Ergebnis entsprechend wörtlich und ungeschliffen aus.
Vergleich mit lokalen LLMs
| Modell | Vergleich zu Dolphin 3.0 | Empfohlen für |
|---|---|---|
| Dolphin 3.0 | Klassisches, unzensiertes Fine-Tune, starke Kontrolle über System-Prompts, sehr beliebt für Schreiben und Rollenspiele. | Nutzer, die lokale Flexibilität und weniger Verweigerungen suchen. |
| Qwen 3.8 | Umfangreicheres mehrsprachiges Ökosystem sowie Ökosystem für Programmierung; neuere Großmodell-Familie, in offiziellen Versionen stärker sicherheitsfokussiert. | Anwender, die Aufgaben auf Japanisch, Chinesisch oder Englisch, Code und RAG benötigen. |
| Gemma 4 | Von Google unterstützte Modellfamilie mit sauberer offizieller Dokumentation und multimodalem Schwerpunkt; standardmäßig weniger unzensiert. | Nutzer, die etablierte Open-Weights-Modelle und Sicherheitsdokumentationen bevorzugen. |
| Llama 3.1 / Llama 4 Fine-Tunes | Riesiges Ökosystem mit zahlreichen unzensierten Derivaten; Dolphin stellt eine bekannte, kuratierte Reihe dar. | Anwender, die maximale Auswahl an Community-Modellen wünschen. |
| Mistral Small 24B | Der Basis-Stil hinter der 24B-Variante ist leistungsstark, allerdings verändert Dolphin das Verhalten bei Instruktionen und Verweigerungen. | Wer ein konventionelleres Instruktionsmodell sucht, bevorzugt möglicherweise Mistral. |
| Nous- / Hermes-Modelle | Ebenfalls stark bei Rollenspielen und der Befolgung von Anweisungen; meist weniger explizit als unzensiert vermarktet. | Nutzer, die kreatives Schreiben und das Verhalten von Agenten vergleichen möchten. |
Lokale Einrichtung
Für die 8B-Version ist Ollama der unkomplizierteste Weg. Die meisten Einrichtungsschritte entfallen hierbei, und die Leistung reicht für schnelle Chat-Tests, Prompt-Experimente und lokale Schreib-Workflows völlig aus.
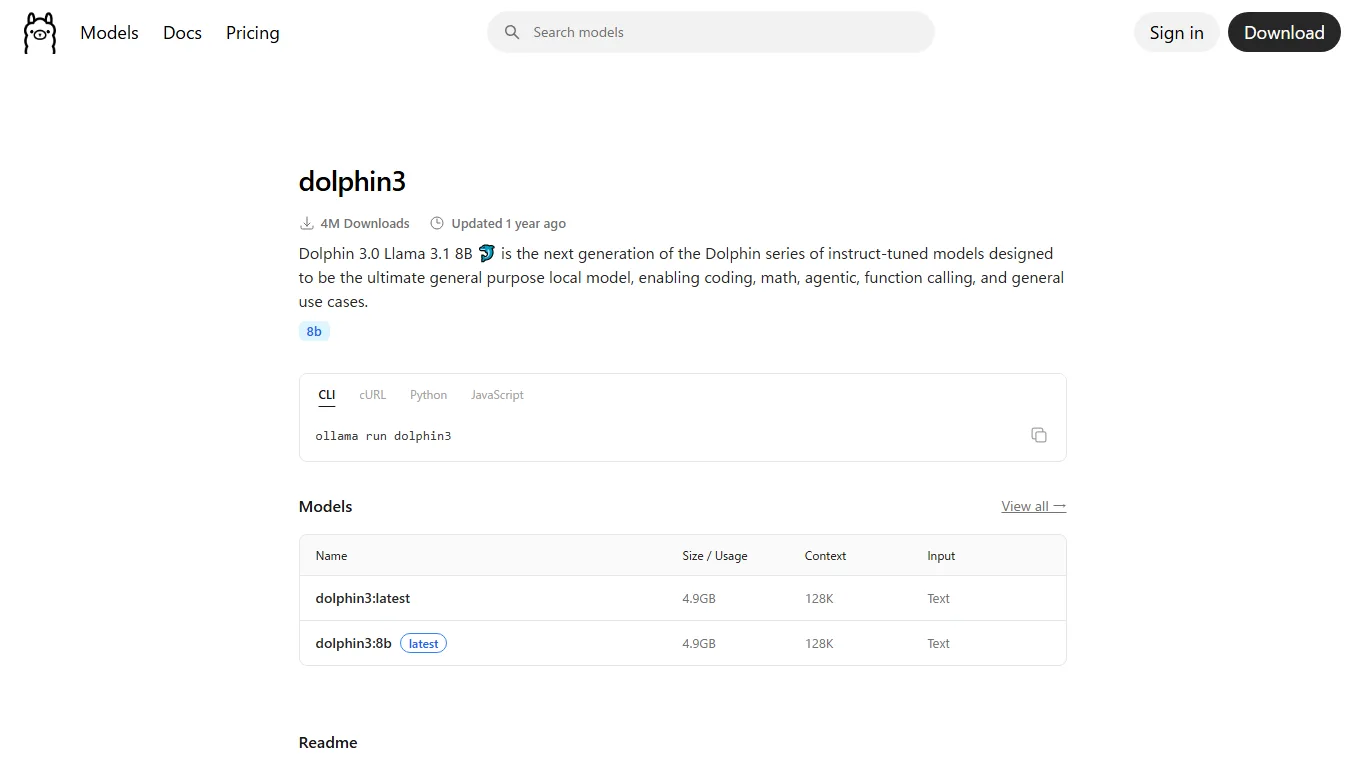
ollama pull dolphin3 ollama run dolphin3Für GGUF-Dateien bieten sich LM Studio oder llama.cpp an. Wer das vollständige Safetensors-Modell in der 24B-Variante nutzen möchte, greift zu Transformers oder einem Serving-Stack wie vLLM, sofern die entsprechende Hardware bereitsteht.
pip install -U transformers accelerate torch safetensors python - <<'PY' from transformers import AutoModelForCausalLM, AutoTokenizer model_id = "dphn/Dolphin3.0-R1-Mistral-24B" tok = AutoTokenizer.from_pretrained(model_id) model = AutoModelForCausalLM.from_pretrained( model_id, torch_dtype="auto", device_map="auto", ) PYGPU-Anforderungen
| Modell | BF16-Schätzwert | Praktischer Ansatz | Hinweise |
|---|---|---|---|
| Dolphin 3.0 Mistral 24B | Ca. 48 GB+ für die Gewichte, mehr bei langem Kontext und KV-Cache | Eine 24GB-GPU ist mit 4-Bit-GGUF/quantisierten Builds und kürzerem Kontext realistisch | Beste Qualität, aber kein ganz unkompliziertes lokales Modell. |
| Dolphin 3.0 Llama 3.1 8B | 16 GB+ ermöglichen eine komfortable Nutzung in BF16 | 6 GB bis 12 GB funktionieren mit GGUF-Quantisierung | Optimales Einsteigermodell für Heim-GPUs. |
| Reiner CPU-Betrieb (GGUF) | Kein VRAM erforderlich, allerdings langsamer | Q4/Q5 GGUF mit llama.cpp oder LM Studio verwenden | Ausreichend für Schreibtests, weniger geeignet für langlaufende Agenten. |
| Online-API/Chat | Keine lokale GPU erforderlich | Nutzung über Dolphin Web, OpenRouter oder andere Anbieter | Gut für Evaluierungen vor dem Download geeignet. |
Der tatsächliche Speicherbedarf hängt von Faktoren wie Quantisierung, Kontextlänge, Batch-Größe, KV-Cache, GPU-Offloading und der genauen Ausführungsumgebung ab. Bei Rollenspielen oder Schreibaufgaben mit langem Kontext wächst der Speicherbedarf rasant. Lädt ein Modell zwar, wird aber extrem langsam oder stürzt ab, sollte die Kontextlänge reduziert werden, anstatt direkt anzunehmen, dass das Modell unbrauchbar ist.
Online-Nutzung bei unzureichender lokaler Hardware
Die offizielle Web-Anlaufstelle von Dolphin ist unter dphn.ai/chat erreichbar, und auch die Hugging Face-Organisation von Dolphin verweist auf die offiziellen Kanäle des Projekts. Dies ist der unkomplizierteste Startpunkt, um sich mit dem Projekt vertraut zu machen, bevor ein lokales Modell heruntergeladen wird.
Für API-basierte Tests erweist sich die Cognitive-Computations-Seite auf OpenRouter als nützlich. Dort werden Modelle von Cognitive Computations aufgelistet, sodass Entwickler Preise, Kontextfenster und Funktionen vergleichen können. Venice ist ein weiterer Online-KI-Chatdienst, den datenschutzorientierte Nutzer und Anwender weniger restriktiver Chats häufig in Betracht ziehen – allerdings sollte dieser als eigenständiger Dienst und nicht als offizielle Dolphin-Plattform verstanden werden.
NSFW- und unzensiertes Verhalten
Dolphin 3.0 gehört zu den bekannteren unzensierten lokalen Modellfamilien. Für die private, lokale Nutzung ist es im Vergleich zu kommerziellen Cloud-Assistenten deutlich bereiter, auf nicht-jugendfreie, rollenspielbezogene oder sensible kreative Prompts einzugehen. Genau das ist der Hauptgrund, warum nach Dolphin häufig mit Begriffen wie NSFW, unzensiert, Rollenspiel (Roleplay) und jailbreak-freies lokales LLM gesucht wird.
Dennoch bedeutet „unzensiert“ nicht harmlos oder grenzenlos. Bei entsprechenden Prompts kann Dolphin Erwachseneninhalte, unsichere Vorschläge, voreingenommene Aussagen oder rechtlich sensible Ergebnisse generieren. Das Modell ersetzt keine eigene Richtlinienentwicklung. Wer es für andere Personen bereitstellt, muss eigene Regeln, Filter, Protokollierungsmechanismen und Verfahren für Missbrauch definieren. Im privaten Rahmen gilt: lokal betreiben und die geltenden lokalen Gesetze sowie Plattformregeln beachten.
Am besten lässt sich Dolphin nicht als magisches Modell ohne Konsequenzen betrachten, sondern als kontrollierbares lokales Fine-Tune. Es glänzt überall dort, wo der System-Prompt Gewicht haben soll und der Anwender die Verantwortung für seine Eingaben übernimmt.
Häufig gestellte Fragen (FAQ)
Ist Dolphin 3.0 wirklich unzensiert?
Es verweigert Anfragen deutlich seltener als herkömmliche gehostete Assistenten und ist fest in der Tradition unzensierter Fine-Tunes verwurzelt. Das genaue Verhalten hängt jedoch stets von der Modellvariante, dem Prompt, der Ausführungsumgebung und eventuell hinzugefügten Moderationsschichten ab.
Mit welchem Dolphin-3.0-Modell sollte ich starten?
Besitzt man einen normalen Desktop-PC, ist Dolphin 3.0 Llama 3.1 8B über Ollama oder GGUF der ideale Einstieg. Wer eine höhere Qualität anstrebt und über ausreichend VRAM oder ein quantisiertes Build verfügt, greift zu Dolphin 3.0 R1 Mistral 24B.
Kann eine RTX 4090 mit 24 GB das 24B-Modell ausführen?
Das vollständige BF16-Modell mit 24 Milliarden Parametern ist für einen komfortablen Betrieb mit 24 GB VRAM zu groß. Mit 4-Bit-GGUF oder anderen quantisierten Builds, kürzerem Kontext und angepassten Einstellungen lässt es sich jedoch realistisch betreiben.
Eignet sich Dolphin für die japanische Sprache?
Es kann auf Japanisch antworten, gilt jedoch nicht primär als japanisches Sprachmodell. Für präzisere japanische Texte sind Qwen oder andere mehrsprachige Modelle oft besser geeignet. Dolphin punktet stattdessen vor allem durch präzise Prompt-Befolgung und unzensiertes Rollenspiel-Verhalten.
Ist die Online-Nutzung von Dolphin sicher?
Online-Anbieter verfügen über eigene Datenschutzbestimmungen, Protokollierungsrichtlinien, Moderationsvorgaben und Nutzungsbedingungen. Bei sensiblen Prompts ist die lokale Nutzung sicherer. Für schnelle Evaluierungen erweisen sich Online-Plattformen als praktisch, solange keine vertraulichen Daten hochgeladen werden.
Darf ich Dolphin kommerziell nutzen?
Es empfiehlt sich, die Lizenz des konkreten Modells sowie des jeweiligen Basismodells oder der GGUF-Konvertierung zu prüfen. Lizenzen und Bestimmungen zur zulässigen Nutzung können zwischen Basisgewichten, Fine-Tunes und quantisierten Uploads variieren.
Fazit
Dolphin 3.0 bleibt eines der saubersten Beispiele für den klassischen Ansatz eines unzensierten lokalen Fine-Tunes. Eine Empfehlung spricht vor allem dann dafür, wenn Anwender kreatives Schreiben, Rollenspiele, agentenbasierte Prompts, Unterstützung beim Programmieren und weniger Verweigerungen als bei gängigen Chat-Assistenten suchen.
Der beste erste Schritt führt über das 8B-Modell mittels Ollama oder GGUF. Das 24B Mistral-Modell stellt bei entsprechender Hardware das ambitioniertere Qualitätsziel dar. Für NSFW- und unzensierte Einsatzzwecke ist das Modell vor allem deshalb so mächtig, weil es die Kontrolle an den Anwender zurückgibt – was im Umkehrschluss bedeutet, dass dieser auch mehr Eigenverantwortung tragen muss.
Quellen
Verwandte Bewertungen
Nucleus Image Review: 17B Sparse MoE, lokales Setup, NSFW-Unterstützung und Apache-2.0-Open-Weights

Mistral AI Test: lokale Modelle, Large 3, Small 4 und NSFW-Politik

Z-Image Review: Turbo, Base, VRAM, LoRA und lokale NSFW-Nutzung
FLUX 3 im Test: Video, Bild, Open Weights und NSFW-Richtlinie
Llama 4 Test: Scout, Maverick, Behemoth, lokale Nutzung und NSFW-Politik
Seedream 5.0 Pro im Test: KI-Bildmodell, API-Zugriff und NSFW-Richtlinie